

데이터 소스 가져오기(Data Source)
데이터 소스는 Feishu, Notion, Yuque 등의 플랫폼 콘텐츠를 지식 베이스에 지속적으로 동기화합니다. 연결을 설정하면 일정에 따라 새 콘텐츠와 수정된 콘텐츠를 가져올 수 있으며, 원본에서 삭제된 콘텐츠는 동기화 설정에 따라 처리합니다.
데이터 소스는 지식 베이스에서 설정합니다. 대상 지식 베이스의 편집 설정을 열고 '데이터 소스' 탭에서 연결을 생성하고 자격 증명을 입력한 뒤 동기화 범위와 주기를 선택합니다. 최초 동기화는 전체 콘텐츠를 가져오고, 이후에는 커넥터의 기능에 따라 증분 업데이트합니다.
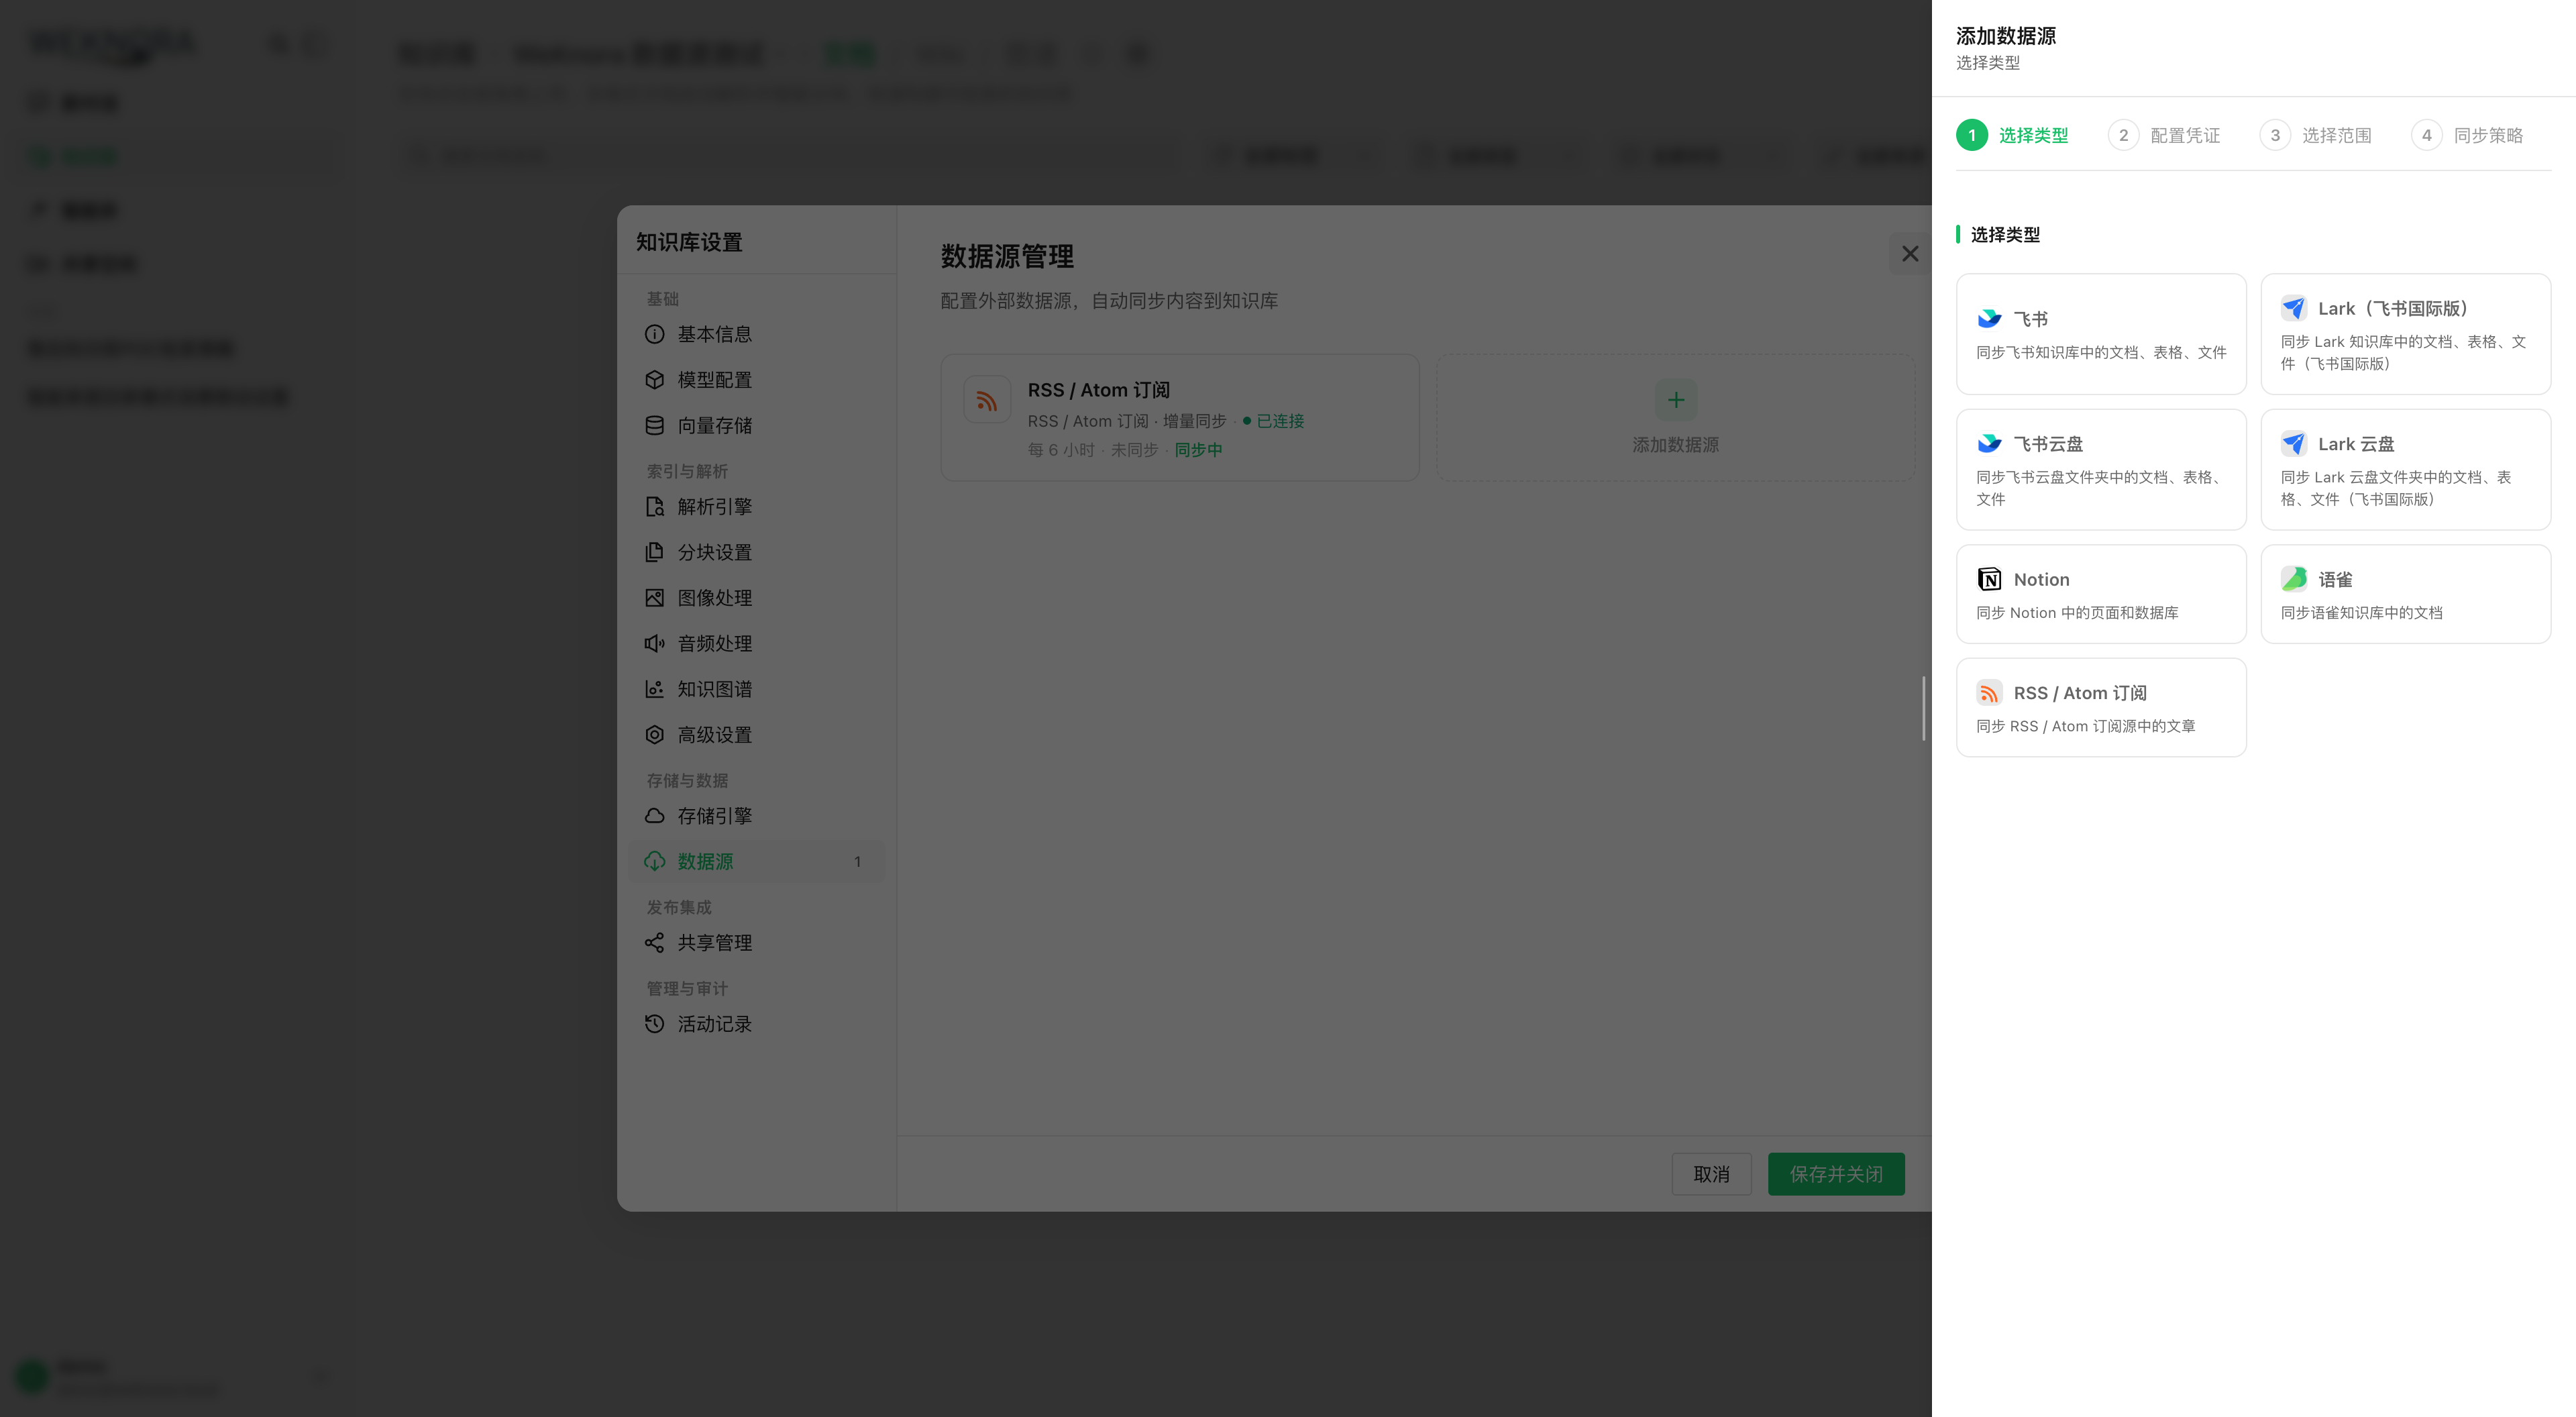
설정된 데이터 소스(유형, 대상 지식 베이스, 마지막 동기화 시간, 상태)와 동기화 로그 진입점을 표시합니다.
website-docs/public/screenshots/datasource-sync.png커넥터는 외부 콘텐츠를 읽고, 스케줄러는 동기화를 시작하며, 서비스 계층은 변경 사항 비교와 지식 수집을 수행합니다.
연결 설정 및 동기화
- 공간 관리자 권한으로 대상 지식 베이스의 '데이터 소스' 설정을 엽니다.
- 커넥터를 선택하고 자격 증명을 입력한 뒤 연결을 테스트하여 필요한 리소스를 나열할 수 있는지 확인합니다.
- 동기화 범위와 주기를 선택하고 저장한 뒤 최초 동기화를 시작합니다.
- 동기화 상태와 로그에서 생성, 업데이트, 건너뛰기, 실패한 콘텐츠가 예상과 일치하는지 확인합니다.
자격 증명을 업데이트할 때는 전체 설정을 제출해야 하며 시스템이 온라인으로 검증합니다. 데이터 소스를 일시 중지하면 이후 예약 동기화가 중단되고, 재개하면 스케줄을 다시 등록합니다.
커넥터 선택
Feishu, Lark, Notion, Yuque는 협업 문서 동기화에, GitLab은 저장소의 문서 디렉터리 동기화에, IMA는 접근 가능한 지식 베이스와 노트 동기화에, RSS는 글 구독에 사용합니다. 커넥터별 지원 형식, 인증, 삭제 감지는 참고 절에서 확인하세요.
변경 사항 및 실패 확인
최초 동기화는 선택한 범위의 콘텐츠를 가져오며, 이후에는 커넥터 커서와 수정 정보를 기준으로 업데이트합니다. 삭제 감지는 커넥터와 동기화 설정에 따라 제한됩니다. RSS의 자연스러운 항목 제거는 원본 문서 삭제로 간주하지 않습니다. 동기화가 실패하면 먼저 로그에서 자격 증명, 리소스 가시성, 파싱 오류를 확인한 뒤 연결을 테스트하고 재시도하세요.
커넥터 및 API 참고
커넥터 구현 상세
커넥터 기능 비교
| Feishu / Lark | Notion | Yuque | RSS / Atom | |
|---|---|---|---|---|
| 소스 디렉터리 | internal/datasource/connector/feishu/ | connector/notion/ | connector/yuque/ | connector/rss/ |
| 유형 식별자 | feishu / lark | notion | yuque | rss |
| 인증 방식 | 기업 자체 개발 앱의 app_id + app_secret(tenant_access_token) | Internal Integration Token(api_key) | 개인/팀 Token(api_token, X-Auth-Token 헤더) | 인증 없음 또는 사용자 정의 요청 헤더(auth_headers) |
| 자격 증명 필드 | app_id, app_secret, base_url(선택적 재정의) | api_key(base_url은 Settings 사용) | api_token, base_url(자체 호스팅 시 선택 사항) | auth_headers(선택 사항, 자격 증명에 속함); feed_urls는 Settings에 속함 |
| 리소스 모델 | Wiki 공간 → 노드 트리(지연 로딩, spaceID:nodeToken 복합 ID) | 페이지/데이터베이스 전체 트리(parent 관계를 포함해 한 번에 반환) | 지식 베이스(book/repo) 평면 목록 | feed URL마다 리소스 하나(평면) |
| 콘텐츠 형식 | 내보내기 API → .docx/.xlsx 파일; drive 파일은 원본 그대로 다운로드 | Block → Markdown; 데이터베이스는 Markdown 표로 변환; 첨부 파일 다운로드 | body Markdown 원문(.md) | Readability 전문 추출 → HTML→Markdown |
| 증분 방식 | 콘텐츠 obj_edit_time 비교(cursor: SpaceNodeTimes) | 페이지/레코드 last_edited_time 비교(cursor: PageEditTimes) | 문서 content_updated_at 비교(cursor: BookDocTimes) | feed 신호 지문 + 콘텐츠 SHA-256 지문 이중 비교 |
| 삭제 감지 | 지원(커서에는 있으나 현재 트리에는 없으면 → IsDeleted; 일부 목록 조회 실패 시 삭제 감지 생략) | 지원("원본에서 삭제"와 "사용자가 선택 해제"를 구분하며 후자는 삭제로 보고하지 않음) | 지원 | 미지원(feed는 오래된 항목을 자연스럽게 밀어냄) |
| 스트리밍 및 재개 가능한 동기화 | 지원(StreamingConnector, 50개 노드 또는 30초마다 checkpoint) | 미지원 | 미지원 | 미지원 |
| 요청 제한 대응 | 429의 Retry-After + 지수 백오프(2s/4s/8s, 최대 3회 재시도); 5xx 재시도 | — | GetDocDetail 호출마다 300ms 간격(개인 token은 약 100 req/5min) | — |
| 부분 실패 | 개별 문서 실패 시 오류 metadata를 담은 자리표시자 항목을 생성하고 동기화 계속 | 개별 페이지 실패 시 로그를 남기고 건너뜀 | 개별 문서 실패 시 자리표시자 항목 생성 | 개별 feed 실패 → PartialFetchError; 전체 실패만 fail로 처리 |
Feishu / Lark(connector/feishu/)
Feishu와 Lark(국제판 open.larksuite.com)는 서로 격리된 두 클라우드에 배포된 동일 제품이며 Wiki/docx/drive API가 완전히 같습니다. 따라서 같은 커넥터 코드를 공유하고 region.go의 Region 구조로 클라우드를 선택합니다(RegionFeishu / RegionLark, 각각 유형 feishu / lark, API 도메인 open.feishu.cn / open.larksuite.com에 대응). 자격 증명의 base_url 필드로 명시적으로 재정의할 수 있습니다(과거 feishu 커넥터를 larksuite로 연결했던 기존 데이터 소스와 호환).
- 인증(
client.go):POST /open-apis/auth/v3/tenant_access_token/internal로 tenant_access_token을 발급받으며, 뮤텍스 잠금 캐시와 만료 갱신을 사용합니다. - 리소스 나열(
ListResources): 3단계 지연 로딩을 사용합니다.parentID==""는 Wiki 공간,parentID==spaceID는 공간의 최상위 노드,parentID=="spaceID:nodeToken"은 해당 노드의 자식 노드를 나열합니다. 초기 버전은 전체 트리를 미리 재귀 순회하여 큰 Wiki에서 시간 초과가 발생했습니다(issue #1672). 현재 재귀 순회는 동기화 시에만 수행합니다.ResolveResourceAncestors는GetWikiNode의parent_node_token을 따라 위로 올라가며 O(depth)로 깊은 위치의 선택 상태를 다시 표시합니다. - 콘텐츠 가져오기(
fetchNodeContent)는obj_type에 따라 분기합니다.docx/doc→ 비동기 내보내기 API(POST /drive/v1/export_tasks)로.docx내보내기;sheet/bitable→.xlsx내보내기;file→ drive 원본 파일 다운로드(PDF/Word/이미지 등);mindnote/slides→ 건너뛰기(콘텐츠 읽기 API 없음).fetchTally로 집계해discovered/fetched/failed/skipped_unsupported by_type요약 로그를 출력하여 "13개를 발견했는데 왜 3개만 동기화했는지" 설명합니다(issue #2136).
- 증분 로직: 커서는
feishuCursor.SpaceNodeTimes(resourceID → nodeToken → editTime)입니다. 변경 판단에는obj_edit_time(문서 콘텐츠 편집 시간)을 사용하며, 제목 변경/위치 이동만 반영하는node_edit_time은 사용하지 않습니다. 가져오기에 실패한 노드는 커서를 진행하지 않습니다(이전 editTime을 유지하므로 다음에 반드시 prev != current가 되어 재시도). 일시적인 내보내기 실패로 문서를 영구적으로 건너뛰는 일을 방지합니다. - FetchStream: 전체/증분 경로를 통합합니다(cursor==nil이면 전체).
feishuStreamCheckpointInterval = 50개 노드를 처리하거나 마지막 checkpoint 이후feishuStreamCheckpointMaxInterval = 30s가 지나면 커서를 디스크에 기록합니다. 후자는 "문서 수는 적지만 각 내보내기가 요청 제한으로 매우 느려" 2시간 시간 초과 전에 checkpoint를 한 번도 저장하지 못하는 상황을 방지합니다. - 오류 분류(
feishuFailure): 원본 오류를 안정적인 i18n code(feishu_auth_or_permission/feishu_rate_limited/feishu_timeout/feishu_server_unavailable/feishu_api_error(+code) /sync_failed)로 분류해 프런트엔드에서 현지화하여 표시합니다. 원본 status/body/log_id는 서버 로그에만 남깁니다.
GitLab(connector/gitlab/)
데이터 소스에서 GitLab을 선택하고 credentials.base_url과 access_token을 입력한 뒤 프로젝트, 브랜치 또는 태그, 디렉터리를 선택합니다. Token은 선택한 프로젝트의 저장소를 읽을 수 있어야 합니다. 비공개 프로젝트의 가시성은 GitLab 자격 증명으로 결정됩니다.
config.settings.projects는 비어 있지 않은 배열이며, 각 항목은 문자열 project_id와 선택적 ref, paths를 포함합니다. ref를 비우면 기본 브랜치를 사용하고, paths를 비우면 저장소 전체를 선택합니다. 디렉터리는 상대 경로와 슬래시를 사용합니다. 먼저 자격 증명을 검증하고 리소스를 탐색한 다음 예약 동기화를 저장하세요.
스트리밍 동기화는 재개 checkpoint를 지원합니다. 증분 동기화는 저장소 커밋 차이로 파일을 업데이트하고, 원본 삭제는 sync_deletions에 따라 처리합니다. 선택한 저장소 파일도 WeKnora의 파일 유형, 크기, 파싱 엔진 검증을 거칩니다. 모든 코드나 바이너리 파일을 바로 수집할 수 있는 것은 아닙니다.
{"credentials":{"base_url":"https://gitlab.example.com","access_token":"<token>"},"settings":{"projects":[{"project_id":"123","ref":"main","paths":["docs"]}]}}Tencent IMA(connector/ima/)
credentials.client_id와 api_key를 입력합니다. base_url은 선택 사항이며 기본값은 https://ima.qq.com입니다. 리소스 트리는 해당 자격 증명으로 볼 수 있는 IMA 지식 베이스와 디렉터리를 나열하며, 선택 결과는 config.resource_ids에 저장합니다. 원본 권한 확인에 실패하거나 리소스가 보이지 않으면 먼저 IMA 자격 증명과 지식 베이스 접근 권한을 확인하세요.
다운로드 가능한 파일은 문서 파싱으로 전달하고 웹페이지 유형은 URL로 가져옵니다. 노트는 note OpenAPI로 본문을 읽습니다. AI 대화와 동영상 파싱에는 사용 가능한 본문 읽기 엔드포인트가 없어 건너뜁니다. 전체 및 증분 동기화를 지원하며, 지식 베이스, 상위 디렉터리, 제목으로 안정적인 식별 정보를 구성합니다. 같은 이름의 파일이 교체되어 media_id가 바뀌면 업데이트를 트리거합니다. 전체 목록 조회에 성공한 뒤에만 삭제를 감지합니다.
{"credentials":{"client_id":"<client-id>","api_key":"<api-key>"},"resource_ids":["<resource-id-from-tree>"]}Feishu/Lark 동기화 기록의 업데이트 시간은 콘텐츠 편집 시간을 사용하여 Wiki 노드 작업 시간만 보고 본문 변경을 놓치는 일을 방지합니다. GitLab과 IMA는 모두 삭제 감지를 지원하며, RSS의 자연스러운 항목 밀려남은 삭제로 간주하지 않습니다.
Notion(connector/notion/)
- 인증: Internal Integration Token(자격 증명 필드
api_key), API 버전NotionAPIVersion = "2026-03-11", 기본 주소https://api.notion.com(Settings.base_url로 재정의 가능). - 리소스 나열: Search API가 보이는 페이지와 데이터베이스를 한 번에 모두 가져와
ParentID가 포함된 전체 트리를 반환합니다. 따라서parentID != ""인 지연 로딩 요청은 바로 빈 결과를 반환하며ResolveResourceAncestors도 추가 처리가 필요하지 않습니다.resolveParentID는 2025-09-03+ API의data_source객체를 처리합니다. 이 객체의parent는 데이터베이스 컨테이너를 가리키므로 실제 워크스페이스 위치는database_parent를 확인해야 합니다. - 가져오기:
fetchPage가 페이지를 재귀 처리합니다.GetBlockChildrenAll로 블록 가져오기 →BlocksToMarkdown(markdown.go)으로 Markdown 변환.file_upload유형 파일 블록은 먼저ResolveBlock으로 임시 다운로드 URL을 얻습니다. 첨부 파일(PDF 등, 이미지는 제외: 이미지는 이미 Markdown 안에로 인라인 포함)은 별도 항목으로 다운로드하여 수집합니다.child_page/child_database블록은 재귀적으로 내려갑니다. 데이터베이스는 두 형태로 처리합니다. 전체 데이터베이스는 Markdown 표 하나로 렌더링하고(buildDatabaseItem, 각 레코드의 블록 콘텐츠 부록 포함), 데이터베이스 레코드가 단독으로 나타나면 "속성 목록 + 블록 콘텐츠"로 렌더링합니다(buildRecordItem). 속성 추출 함수propertyToString은 일반적으로type체인을 따라가며 22가지 속성 유형을 모두 처리합니다. 속성 이름은 알파벳순으로 정렬해 증분 비교의 결정성을 보장합니다. - 증분 로직: 최초 동기화(빈 커서)는
FetchAll에 바로 위임하고 반환 항목의UpdatedAt으로 커서를 구성합니다. 이후 동기화에서는discoverAllResources가 Search API + BFS로 선택한 루트 아래의 모든 후손을 찾고 페이지별last_edited_time을 비교합니다. 데이터베이스는fetchDatabaseIncremental을 사용하며, 레코드 하나라도 바뀌면 표 전체를 다시 만듭니다. - 삭제와 선택 해제 구분: 원본에서 사라진 페이지는
IsDeleted로 보고합니다. 여전히 보이지만 사용자가 조상의 선택을 해제해 더 이상 도달할 수 없는 페이지는 excluded 집합에 넣으며 삭제로 잘못 보고하지 않습니다.computeExcludedSet은 "사용자가 한 번도 보지 못한 새 페이지"가 제외되지 않도록 보장합니다. 선택한 부모 노드에는 새 자식 페이지가 여전히 자동으로 포함됩니다.
Yuque(connector/yuque/)
- 인증: 개인 Token(Yuque 설정 → Token) 또는 팀 Token을 사용합니다. 자격 증명 필드는
api_token(요청 헤더X-Auth-Token)과 선택적base_url(기업 자체 호스팅 도메인, scheme이 없으면https://자동 추가)입니다. - 리소스 나열:
GET /api/v2/user로 token의 신원을 확인합니다.type=="Group"이면 팀 token이므로 팀 repo를 바로 나열합니다. 그 외에는 개인 repo + 가입한 group의 repo를 나열합니다(가입한 group이 없으면 Yuque가 404를 반환하며 빈 결과로 처리). 평면book리소스 목록을 출력하고 ExternalID로 안정적으로 정렬합니다. - 가져오기(
walk, 전체/증분 공용):ListBookDocs로 문서 나열 →type != "Doc"(Sheet/Thread/Board/Table 제외) 및status != "1"(초안 제외) 필터링 → 요청 제한을 피하도록 각GetDocDetail사이에 300ms sleep →format이markdown/lake이면bodyMarkdown 원문을 수집합니다(html 등 다른 형식은 방어적으로 건너뛰고skip_reason기록). - 증분 로직: 커서
yuqueCursor.BookDocTimes(bookID → docID → content_updated_at)가 같으면 건너뜁니다. 삭제 감지: 커서에는 있으나 현재 목록에는 없으면 →IsDeleted.
DingTalk 문서(connector/dingtalk/)
- 인증: 기업 내부 앱의 Client ID, Client Secret과 대상 지식 베이스 접근 권한이 있는 작업자의 Union ID를 사용합니다.
Wiki.Workspace.Read,Wiki.Node.Read,Storage.File.Read권한을 활성화한 뒤 앱을 게시합니다. - 범위: 지식 베이스, 폴더 또는 개별
ALIDOC/adoc온라인 문서를 선택하여 공개 Wiki / Blocks API로 Markdown으로 변환합니다. 현재 DingTalk 스프레드시트나 일반 업로드 첨부 파일은 가져오지 않으며, 비동기 내보내기 콜백에도 의존하지 않습니다. - 동기화: 문서
modifiedTimestamp(밀리초)를 기준으로 증분 읽기를 수행하고, 없으면modifiedTime으로 대체합니다. 겹치는 선택 범위는 병합합니다. 전체 동기화에서도 이전 커서와 대조해 삭제를 확인하므로sync_mode=full에서 삭제가 누락되지 않습니다. 디렉터리 순회가 불완전하면 삭제를 보류합니다. - 본문: 공개 Blocks API는 문서 루트 아래의 1단계 블록만 반환합니다. 강조 블록 같은 컨테이너 응답에
children이 있으면 계속 렌더링하고, 없으면 metadata에nested_blocks_unavailable을 표시해 불완전한 본문을 완전한 성공으로 처리하지 않습니다. - 검증: 연결 테스트는 지식 베이스를 나열하고 루트 노드 목록을 탐색하며, 루트 아래 온라인 문서가 있으면 Blocks를 시험 읽기하여
Wiki.Node.Read/Storage.File.Read누락을 일찍 발견합니다. - 실패 및 복구: 리소스가 유효하지 않아도 다른 범위의 처리는 막지 않습니다. 실패한 범위와 본문 가져오기에 실패한 문서는 이전 버전을 유지하여 재시도합니다. 어느 범위든 완전하게 스캔할 수 없으면 삭제를 보류하고 확인 대기 기록을 유지합니다. 유효하지 않은 개별 선택 항목은 권한을 확인하거나 다시 선택해야 합니다.
- 삭제 스위치: 삭제 동기화를 켜야 원본에서 삭제된 것으로 확인된 로컬 지식을 제거합니다. 접근할 수 없는 리소스를 곧바로 삭제된 것으로 간주하지 않습니다.
RSS / Atom(connector/rss/)
- 설정:
feed_urls(줄바꿈/쉼표 구분, 여러 항목 중복 제거)는 Settings에 저장합니다(비밀이 아니므로 UI에서 직접 편집 가능).auth_headers(줄마다Name: Value하나, feed 요청에만 추가하고 타사 글 페이지에는 절대 전송하지 않음)는 Credentials에 저장하고 암호화합니다.HasConfiguredCredentials는 RSS를 특별 처리하여auth_headers가 있어야 자격 증명이 설정된 것으로 봅니다. - 가져오기:
gofeed로 RSS/Atom/JSON feed를 파싱합니다. 항목에 링크가 있으면 원문 페이지를 가져와 readability 추출기를 적용합니다. 성공하면 전문을 사용하고, 실패하면 feed 자체 콘텐츠(content:encoded/description)로 대체합니다. HTML은html-to-markdown/v2로 Markdown으로 변환합니다. 항목 ID는GUID > Link > Title순서로 첫 번째 비어 있지 않은 값을 사용합니다. - 증분 로직: 이중 지문을 사용합니다. 먼저 feed 측 신호 지문(
feedSignalFingerprint)을 비교하여 바뀌지 않았으면 원문 페이지도 가져오지 않습니다. 다음으로 가져온 콘텐츠의 SHA-256 지문을 비교합니다. 삭제 동기화는 지원하지 않습니다(feed는 오래된 항목을 자연스럽게 제거합니다). - 부분 실패: 개별 feed 가져오기/파싱 실패 시 이전 커서를 유지하고(
copyFeedCursor) 나머지 feed를 계속 처리합니다. 최종적으로datasource.PartialFetchError로 보고합니다(SyncLog에는partial기록). 모든 feed가 실패해야 전체 오류로 처리합니다.
데이터 소스 수명 주기 및 REST API
라우트는 internal/router/router.go의 RegisterDataSourceRoutes에서 등록합니다(읽기는 Viewer+, 쓰기는 Admin+).
| 메서드 및 경로 | 권한 | 설명 |
|---|---|---|
GET /api/v1/datasource/types | Viewer | 사용 가능한 커넥터 metadata 목록(ListAvailableConnectors, Priority순 정렬) |
POST /api/v1/datasource/validate-credentials | Admin | 원시 자격 증명으로 연결 테스트(DB에 저장하지 않음), 생성 마법사의 '연결 테스트' 버튼에서 사용 |
POST /api/v1/datasource | Admin | 데이터 소스 생성(KB의 테넌트 소유권 검증 → 커넥터 유형 검증 → 온라인 Validate → DB 저장 → cron 등록) |
GET /api/v1/datasource?kb_id= | Viewer | 지식 베이스별 데이터 소스 목록(가장 최근 SyncLog 포함) |
GET /api/v1/datasource/:id | Viewer | 상세 정보 |
PUT /api/v1/datasource/:id | Admin | 업데이트(자격 증명 필드는 무시; 설정이 실제로 바뀌고 기존 자격 증명이 있을 때만 온라인 검증; cron도 업데이트) |
DELETE /api/v1/datasource/:id | Admin | 소프트 삭제 + cron 제거 + pending/running SyncLog 취소 |
PUT /api/v1/datasource/:id/credentials | Admin | 자격 증명 원자적 교체(자격 증명 암호화 저장 참고) |
DELETE /api/v1/datasource/:id/credentials/:field | Admin | 자격 증명 비우기(field는 credentials만 허용) |
POST /api/v1/datasource/:id/validate | Admin | 저장된 데이터 소스 연결 테스트; 실패 시 status=error, 성공 시 error 상태 해제 |
GET /api/v1/datasource/:id/resources?parent_id= | Viewer | 외부 시스템에서 선택 가능한 리소스 나열(parent_id로 지연 로딩 확장 지원) |
POST /api/v1/datasource/:id/resource-ancestors | Viewer | 선택한 리소스의 조상 체인 해석(편집 시 깊은 위치의 선택 상태 표시) |
POST /api/v1/datasource/:id/sync | Admin | 수동 동기화 시작(SyncLog 생성 + Asynq 작업 큐 등록) |
POST /api/v1/datasource/:id/pause / resume | Admin | 일시 중지/재개(cron도 제거/재등록) |
GET /api/v1/datasource/:id/logs, GET /api/v1/datasource/logs/:log_id | Viewer | 동기화 이력 |
모든 :id 경로는 먼저 getOwnedDataSource → getOwnedKnowledgeBase를 거쳐 테넌트 격리를 검증합니다(데이터 소스가 속한 KB는 현재 테넌트 소유여야 하며 API Key의 KB 권한 검사도 통과해야 합니다).
수명 주기 상태 전이:
동기화 및 저장 참고
동기화 스케줄링(internal/datasource/scheduler.go)
Scheduler는 robfig/cron(cron.WithSeconds(), 초 단위의 6필드 표현식 지원)을 기반으로 SyncSchedule이 설정된 각 active 데이터 소스의 cron entry를 유지합니다. 서비스 시작 시 Start()가 DB에서 모든 active 데이터 소스를 불러와 일괄 등록합니다.
robfig/cron은 절대 벽시계 시간에 따라 실행되므로(예: 0 0 * * * *는 항상 정각에 실행), 다중 인스턴스 배포에서는 모든 인스턴스가 동시에 실행됩니다. 중복 제거에는 두 단계 메커니즘을 사용합니다.
- DB 수준 중첩 방지:
syncLogRepo.HasRunningSync— 이전 동기화가 아직 running이면 이번 실행을 건너뜁니다(동기화 시간이 cron 간격보다 길 때 중첩 실행 방지). - Redis 수준 인스턴스 간 중복 제거: 결정적인
asynq.TaskID = "dssync:<dsID>:<yyyyMMddHHmm>"(분 단위로 절삭)를 사용합니다. 같은 분에는 모든 인스턴스가 같은 TaskID를 생성하므로 Redis가 하나만 큐 등록에 성공하도록 보장합니다. 나머지는asynq.ErrTaskIDConflict를 받고 해당 SyncLog를canceled로 표시합니다("deduplicated: another instance enqueued first").
큐 등록 매개변수: 큐 types.QueueSync, MaxRetry(5), Timeout(2*time.Hour). 작업 유형은 types.TypeDataSourceSync("datasource:sync")이며, internal/router/task.go의 mux.HandleFunc(types.TypeDataSourceSync, params.DataSourceService.ProcessSync)가 소비합니다.
동기화 실행 및 지식 수집(datasource_service.go)
ProcessSync는 Asynq 작업 핸들러이며 전체 흐름은 아래 시퀀스 다이어그램에 나와 있습니다. 핵심 사항:
- 방어적 취소: 데이터 소스나 지식 베이스가 이미 삭제되었으면 SyncLog를
canceled로 설정하고 nil을 반환합니다(재시도하지 않음). - 두 가지 가져오기 경로: 커넥터가
StreamingConnector를 구현하면processSyncStreaming(스트리밍)을 사용합니다. 그 외에는ForceFull || SyncMode==full이면FetchAll, 아니면ParseSyncCursor()의 커서와 함께FetchIncremental(배치)을 사용합니다. - 스트리밍 경로의 커서 전략(
streamStartCursor): 사용자가 시작한 전체 동기화는 첫 시도에 커서를 버리고 전체를 가져옵니다. Asynq 재시도(attempt > 0)와 모든 증분 동기화는 마지막 checkpoint부터 이어갑니다. - 수집 핵심
applyFetchedItem→ingestItem:IsDeleted=true이고sync_deletions=true이면 테넌트, 지식 베이스, 데이터 소스 ID, external_id로 해당 지식을 찾아 실제 삭제합니다. 삭제 동기화가 꺼져 있으면 기존 지식을 유지합니다. 삭제 기능은 커넥터가 신뢰할 수 있는 삭제 감지를 제공하는지에도 달려 있습니다.Content바이트가 있으면 →multipart.FileHeader로 감싸KnowledgeService.CreateKnowledgeFromFile로 전달합니다(전체 문서 파싱 파이프라인).URL만 있으면 →CreateKnowledgeFromURL로 전달해 WeKnora가 다운로드하고 파싱합니다.- 업데이트 = 삭제 후 생성: metadata의
external_id로 기존 지식 항목을 찾으면 먼저DeleteKnowledge후 다시 생성하고 Updated로 집계합니다. - 중복 파일(
DuplicateKnowledgeError)은 Skipped로 집계하며 실패가 아닙니다. - 각 항목에 metadata를 자동으로 추가합니다.
external_id,source_resource_id,datasource_id와 커넥터가 추가한 metadata입니다. 원본에서 시간을 제공하면 UTC RFC3339 형식의source_created_at/source_updated_at도 저장합니다. 이는 원본 문서의 시간이며 WeKnora의 created_at/updated_at과 구분됩니다.
- 자동 태그 지정:
resolveAutoTagIDs가 대상 KB에서 데이터 소스 이름으로 태그를 FindOrCreate하고 모든 동기화 항목에 자동으로 붙여 KB에서 출처를 쉽게 식별하도록 합니다. 태그 지정 실패는 동기화를 막지 않습니다. - 결과 상태: 모든 항목 실패 →
failed(allFetchedItemsFailedError); RSS 일부 feed 실패(PartialFetchError) 또는 스트리밍 경로에 실패 문서가 있음 →partial; 그 외 →success. 실패 샘플은SyncItemError형태로 최대 100개 보관합니다. - 가져오기 실패 시에도 커넥터가 새 커서를 반환했다면(RSS 등) 커서를 저장하여 일시적인 장애 이후 전체를 다시 가져와야 하는 일을 방지합니다.
자격 증명 암호화 저장
자격 증명은 쓰기, 읽기, API 응답 시 각각 처리합니다.
1. 쓰기 시 암호화 — DataSourceConfig.ToJSON()(internal/types/datasource.go):
// SYSTEM_AES_KEY가 설정되어 있으면 Credentials의 각 문자열 값을 직렬화 전에
// AES-256-GCM으로 암호화합니다. 자격 증명이 DB로 들어가는 유일한 쓰기 경로입니다(GORM의 JSON
// 타입은 바이트를 그대로 전달). 따라서 여기서 암호화하면 DataSource.Config를 항상 암호문으로 저장할 수 있습니다.
if key := utils.GetAESKey(); key != nil && len(out.Credentials) > 0 {
    ...
    if enc, err := utils.EncryptAESGCM(s, key); err == nil { encCreds[k] = enc }
}
2. 읽기 시 복호화 — DataSource.ParseConfig(): 세 가지 경우를 투명하게 처리합니다. 빈 문자열은 그대로 반환하고, enc:v1: 접두사가 없는 기존 평문도 그대로 반환합니다(마이그레이션 불필요). 암호문은 SYSTEM_AES_KEY로 복호화합니다. 복호화 실패(키 분실/교체) 시 해당 자격 증명 필드를 비우고 UI에 '자격 증명 미설정'을 표시합니다. 사용자가 다시 입력하면 되며 데이터 소스의 다른 설정은 사라지지 않습니다.
3. 독립적인 자격 증명 하위 리소스 — internal/handler/datasource_credentials.go: 자격 증명은 일반 PUT /datasource/:id가 아니라 별도 /credentials 하위 리소스를 사용합니다. 전체를 원자적으로 교체하여 커넥터가 완전한 자격 증명을 한 번에 받도록 합니다.
PUT /api/v1/datasource/:id/credentials— 자격 증명 map 전체를 교체하고 즉시 커넥터Validate로 온라인 검증합니다(유효하지 않으면 즉시 오류 반환).DELETE /api/v1/datasource/:id/credentials/credentials— 전체 비우기.- 응답에는 암호문/평문을 절대 돌려주지 않으며
{"credentials": {"configured": true/false}}만 반환합니다. 목록/상세 API도dto.NewDataSourceResponse직렬화 시 구조적으로Credentials를 제거합니다.
일반 업데이트 API UpdateDataSource(datasource_service.go)는 DB에 저장된 기존 자격 증명을 강제로 유지합니다. 요청 본문에 credentials가 있어도 무시하고 경고 로그를 남깁니다. 또한 StripNonSecretCredentials가 credentials에 잘못 들어간 비밀이 아닌 필드를 제거합니다(현재는 RSS의 feed_urls만 해당하며, 이는 Settings에 속합니다).
보안 제한(internal/datasource/httpclient.go 및 errors.go)
httpclient.go는 모든 커넥터가 공유하는 두 가지 SSRF 방어 진입점을 제공합니다.
// ValidateConnectorBaseURL은 커넥터 base_url의 SSRF 정책을 검증합니다(빈 값은 허용하고 호출자가 기본값 적용).
func ValidateConnectorBaseURL(rawURL string) error {
    ...
    if err := utils.ValidateURLForSSRF(url); err != nil { ... }
}

// NewConnectorHTTPClient는 리디렉션 및 연결 시 SSRF 방어를 적용하는 HTTP 클라이언트를 반환합니다.
func NewConnectorHTTPClient(timeout time.Duration) *http.Client {
    cfg := utils.DefaultSSRFSafeHTTPClientConfig()
    cfg.Timeout = timeout
    return utils.NewSSRFSafeHTTPClient(cfg)
}
하위 internal/utils/security.go는 사설 주소, 루프백 주소, link-local 등의 대상을 거부합니다. 또한 초기 URL만 검증하는 대신 리디렉션마다, 실제 연결 시마다 다시 검증하여 악성 feed나 사용자 정의 base_url이 WeKnora를 내부망 서비스로 유도하지 못하도록 합니다. 각 커넥터의 parseXXXConfig는 base_url에 ValidateConnectorBaseURL을 호출합니다.
errors.go는 모듈 수준 sentinel 오류(ErrConnectorNotFound, ErrDataSourceInvalid, ErrInvalidCredentials, ErrSyncFailed 등)와 PartialFetchError를 정의합니다. 후자는 일부 리소스는 성공하고 일부는 실패했음을 뜻합니다. 호출자는 확보한 항목을 처리하고 커서를 저장하며 Details를 partial 상태로 사용자에게 표시해야 합니다.
핵심 추상화: Connector 인터페이스
모든 커넥터는 internal/datasource/connector.go의 Connector 인터페이스를 구현해야 합니다.
type Connector interface {
    // Type은 커넥터 유형 식별자를 반환합니다(예: "feishu", "notion").
    Type() string
    // Validate는 실제 외부 API 호출로 설정과 자격 증명의 유효성을 검증합니다.
    Validate(ctx context.Context, config *types.DataSourceConfig) error
    // ListResources는 동기화 가능한 리소스(문서, 공간, 폴더 등)를 나열합니다.
    // parentID는 계층형 리소스의 지연 로딩을 지원합니다: ""=최상위; 비어 있지 않음=해당 리소스의 직계 자식.
    ListResources(ctx context.Context, config *types.DataSourceConfig, parentID string) ([]types.Resource, error)
    // ResolveResourceAncestors는 선택한 리소스의 조상 체인을 해석해 지연 로딩 선택기에 깊은 선택 항목을 표시합니다.
    ResolveResourceAncestors(ctx context.Context, config *types.DataSourceConfig, resourceIDs []string) ([]string, error)
    // FetchAll은 지정한 리소스를 전체 동기화합니다.
    FetchAll(ctx context.Context, config *types.DataSourceConfig, resourceIDs []string) ([]types.FetchedItem, error)
    // FetchIncremental은 커서 기반 증분 동기화 후 변경 항목과 다음 동기화용 새 커서를 반환합니다.
    FetchIncremental(ctx context.Context, config *types.DataSourceConfig, cursor *types.SyncCursor) ([]types.FetchedItem, *types.SyncCursor, error)
}
선택적 확장: StreamingConnector(스트리밍 및 재개 가능한 동기화)
StreamingConnector는 항목별 가져오기, 수집, 커서 저장을 지원합니다. 대규모 동기화에 적합하며 전체 콘텐츠를 한 번에 캐시하는 메모리 사용량을 줄입니다.
type StreamHandler interface {
    // Emit은 가져온 항목 하나를 수집합니다. 오류를 반환하면 전체 스트림을 중단합니다.
    Emit(ctx context.Context, item types.FetchedItem) error
    // Checkpoint는 커서 스냅샷을 동기적으로 저장합니다(증분이 아닌 완전히 재개 가능한 스냅샷이어야 함).
    Checkpoint(ctx context.Context, cursor *types.SyncCursor) error
}

type StreamingConnector interface {
    Connector
    FetchStream(ctx context.Context, config *types.DataSourceConfig,
        cursor *types.SyncCursor, h StreamHandler) (*types.SyncCursor, error)
}
작업 시간 초과 후 가장 최근 checkpoint부터 처리를 이어갈 수 있습니다. Asynq 동기화 작업의 시간 제한은 2시간이며, 스트리밍 경로는 항목별로 진행하여 모든 파일 본문을 캐시하지 않습니다. Feishu/Lark와 GitLab 커넥터는 모두 StreamingConnector를 구현합니다. DingTalk은 현재 batch FetchAll/FetchIncremental/FetchAllFromCursor를 사용하므로, 매우 큰 지식 베이스는 모든 Markdown을 한 번에 로드하지 않도록 증분 모드를 권장합니다.
ConnectorRegistry: 등록 및 조회
ConnectorRegistry는 단순한 map[string]Connector 레지스트리입니다. 실제 등록은 internal/container/container.go의 initConnectorRegistry()에서 수행합니다.
registry.Register(feishuConnector.NewConnector(feishuConnector.RegionFeishu))  // feishu
registry.Register(feishuConnector.NewConnector(feishuConnector.RegionLark))    // lark(국제판, 같은 구현에 다른 Region)
registry.Register(drive.NewDriveConnector(core.RegionFeishuDrive))             // feishu_drive
registry.Register(drive.NewDriveConnector(core.RegionLarkDrive))               // lark_drive
registry.Register(notionConnector.NewConnector())                              // notion
registry.Register(yuqueConnector.NewConnector())                               // yuque
registry.Register(dingtalkConnector.NewConnector())                            // dingtalk
registry.Register(imaConnector.NewConnector())                                 // ima
registry.Register(rssConnector.NewConnector())                                 // rss
registry.Register(gitlabConnector.NewConnector())                              // gitlab
참고:
connector.go의ConnectorMetadataRegistry에는 아직 구현되지 않은 커넥터(Confluence, GitHub, Google Drive, OneDrive, Web Crawler, Slack, IMAP 등)도 포함되어 있습니다. 현재 실제 등록되어 사용 가능한 유형은feishu,lark,feishu_drive,lark_drive,notion,yuque,dingtalk,ima,rss,gitlab입니다. 미등록 유형은 데이터 소스 생성 시connectorRegistry.Get()이ErrConnectorNotFound로 거부합니다.
데이터 모델(internal/types/datasource.go)
| 구조 | 설명 |
|---|---|
DataSource | 데이터 소스 설정 엔티티(테이블 data_sources). 주요 필드: Type(커넥터 유형), Config(JSONB, 암호화된 자격 증명 포함), SyncSchedule(cron 표현식), SyncMode(incremental/full), Status(active/paused/error/deleted), ConflictStrategy, SyncDeletions, LastSyncCursor(증분 커서 JSONB), LastSyncAt, LastSyncResult, SyncLogRetentionDays |
SyncLog | 단일 동기화 실행 기록(테이블 sync_logs). 상태: running/success/partial/failed/canceled; 집계: ItemsTotal/Created/Updated/Deleted/Skipped/Failed; Result에 SyncResult JSON 저장 |
DataSourceConfig | 복호화된 설정 구조: Type + Credentials map[string]interface{} + ResourceIDs []string(선택한 리소스) + Settings map[string]interface{}(비밀이 아닌 설정) |
Resource | 외부 시스템에서 선택 가능한 리소스: ExternalID, Name, Type, URL, ParentID, HasChildren, ModifiedAt, Metadata |
FetchedItem | 가져온 문서 하나: ExternalID, Title, Content []byte, ContentType, FileName, URL, UpdatedAt, Metadata, IsDeleted, SourceResourceID |
SyncCursor | 증분 커서: LastSyncTime + ConnectorCursor map[string]interface{}(커넥터 사용자 정의 구조) |
SyncResult | 동기화 결과 요약 + Errors []SyncItemError(실패 샘플, 최대 100개, maxSyncResultErrors 참고) |
SyncItemError | 사용자에게 표시하는 실패 샘플: 안정적인 i18n Code + 보간 Params + 대체용 Message; 원본 API 상태 코드/응답 본문은 서버 로그에만 유지 |
DataSourceSyncPayload | Asynq 작업 페이로드: DataSourceID, TenantID, SyncLogID, ForceFull, Trigger(manual/schedule) |
참고
- 커넥터 개발 가이드(코드와 함께 관리):
internal/datasource/CONNECTOR_IMPLEMENTATION_GUIDE.md - 모듈 설명(코드와 함께 관리):
internal/datasource/README.md
구현 참고
- 커넥터 프레임워크 및 구현:
internal/datasource/(connector.go,scheduler.go,httpclient.go,errors.go,connector/의 각 구현) - HTTP API 계층:
internal/handler/datasource.go,internal/handler/datasource_credentials.go - 비즈니스 서비스 계층:
internal/application/service/datasource_service.go - 데이터 모델:
internal/types/datasource.go