

Agent 엔진
에이전트는 지식 베이스 검색, 웹 검색, 외부 도구를 조합하여 여러 단계로 이루어진 작업을 처리할 수 있습니다. 여러 계약서의 조항 비교가 그 예입니다. 지능형 추론 모드는 질문에 따라 도구를 선택해 여러 차례 호출한 뒤, 얻은 결과를 바탕으로 답변을 생성합니다.
대화창 상단에서 빠른 질의응답 또는 지능형 추론을 선택할 수 있습니다.
| 모드 | 적합한 작업 | 실행 특성 |
|---|---|---|
| 빠른 질의응답(quick-answer) | 문서 기반 사실 조회 | 검색 후 답변을 생성하며, 일반적으로 호출 횟수가 적습니다 |
| 지능형 추론(smart-reasoning) | 여러 문서 분석, 웹 조회 또는 도구 작업 | 여러 차례 호출할 수 있으며, 소요 시간과 사용량은 작업에 따라 달라집니다 |
「에이전트」 페이지에서 사용자 지정 에이전트를 만들고 모드와 모델을 선택하며 지식 베이스 범위를 제한할 수 있습니다. 프롬프트, 웹 검색, MCP 도구, 스킬도 설정할 수 있습니다. 저장한 에이전트는 웹 대화에 사용하거나 IM 또는 임베드 채널에 연결할 수 있습니다.
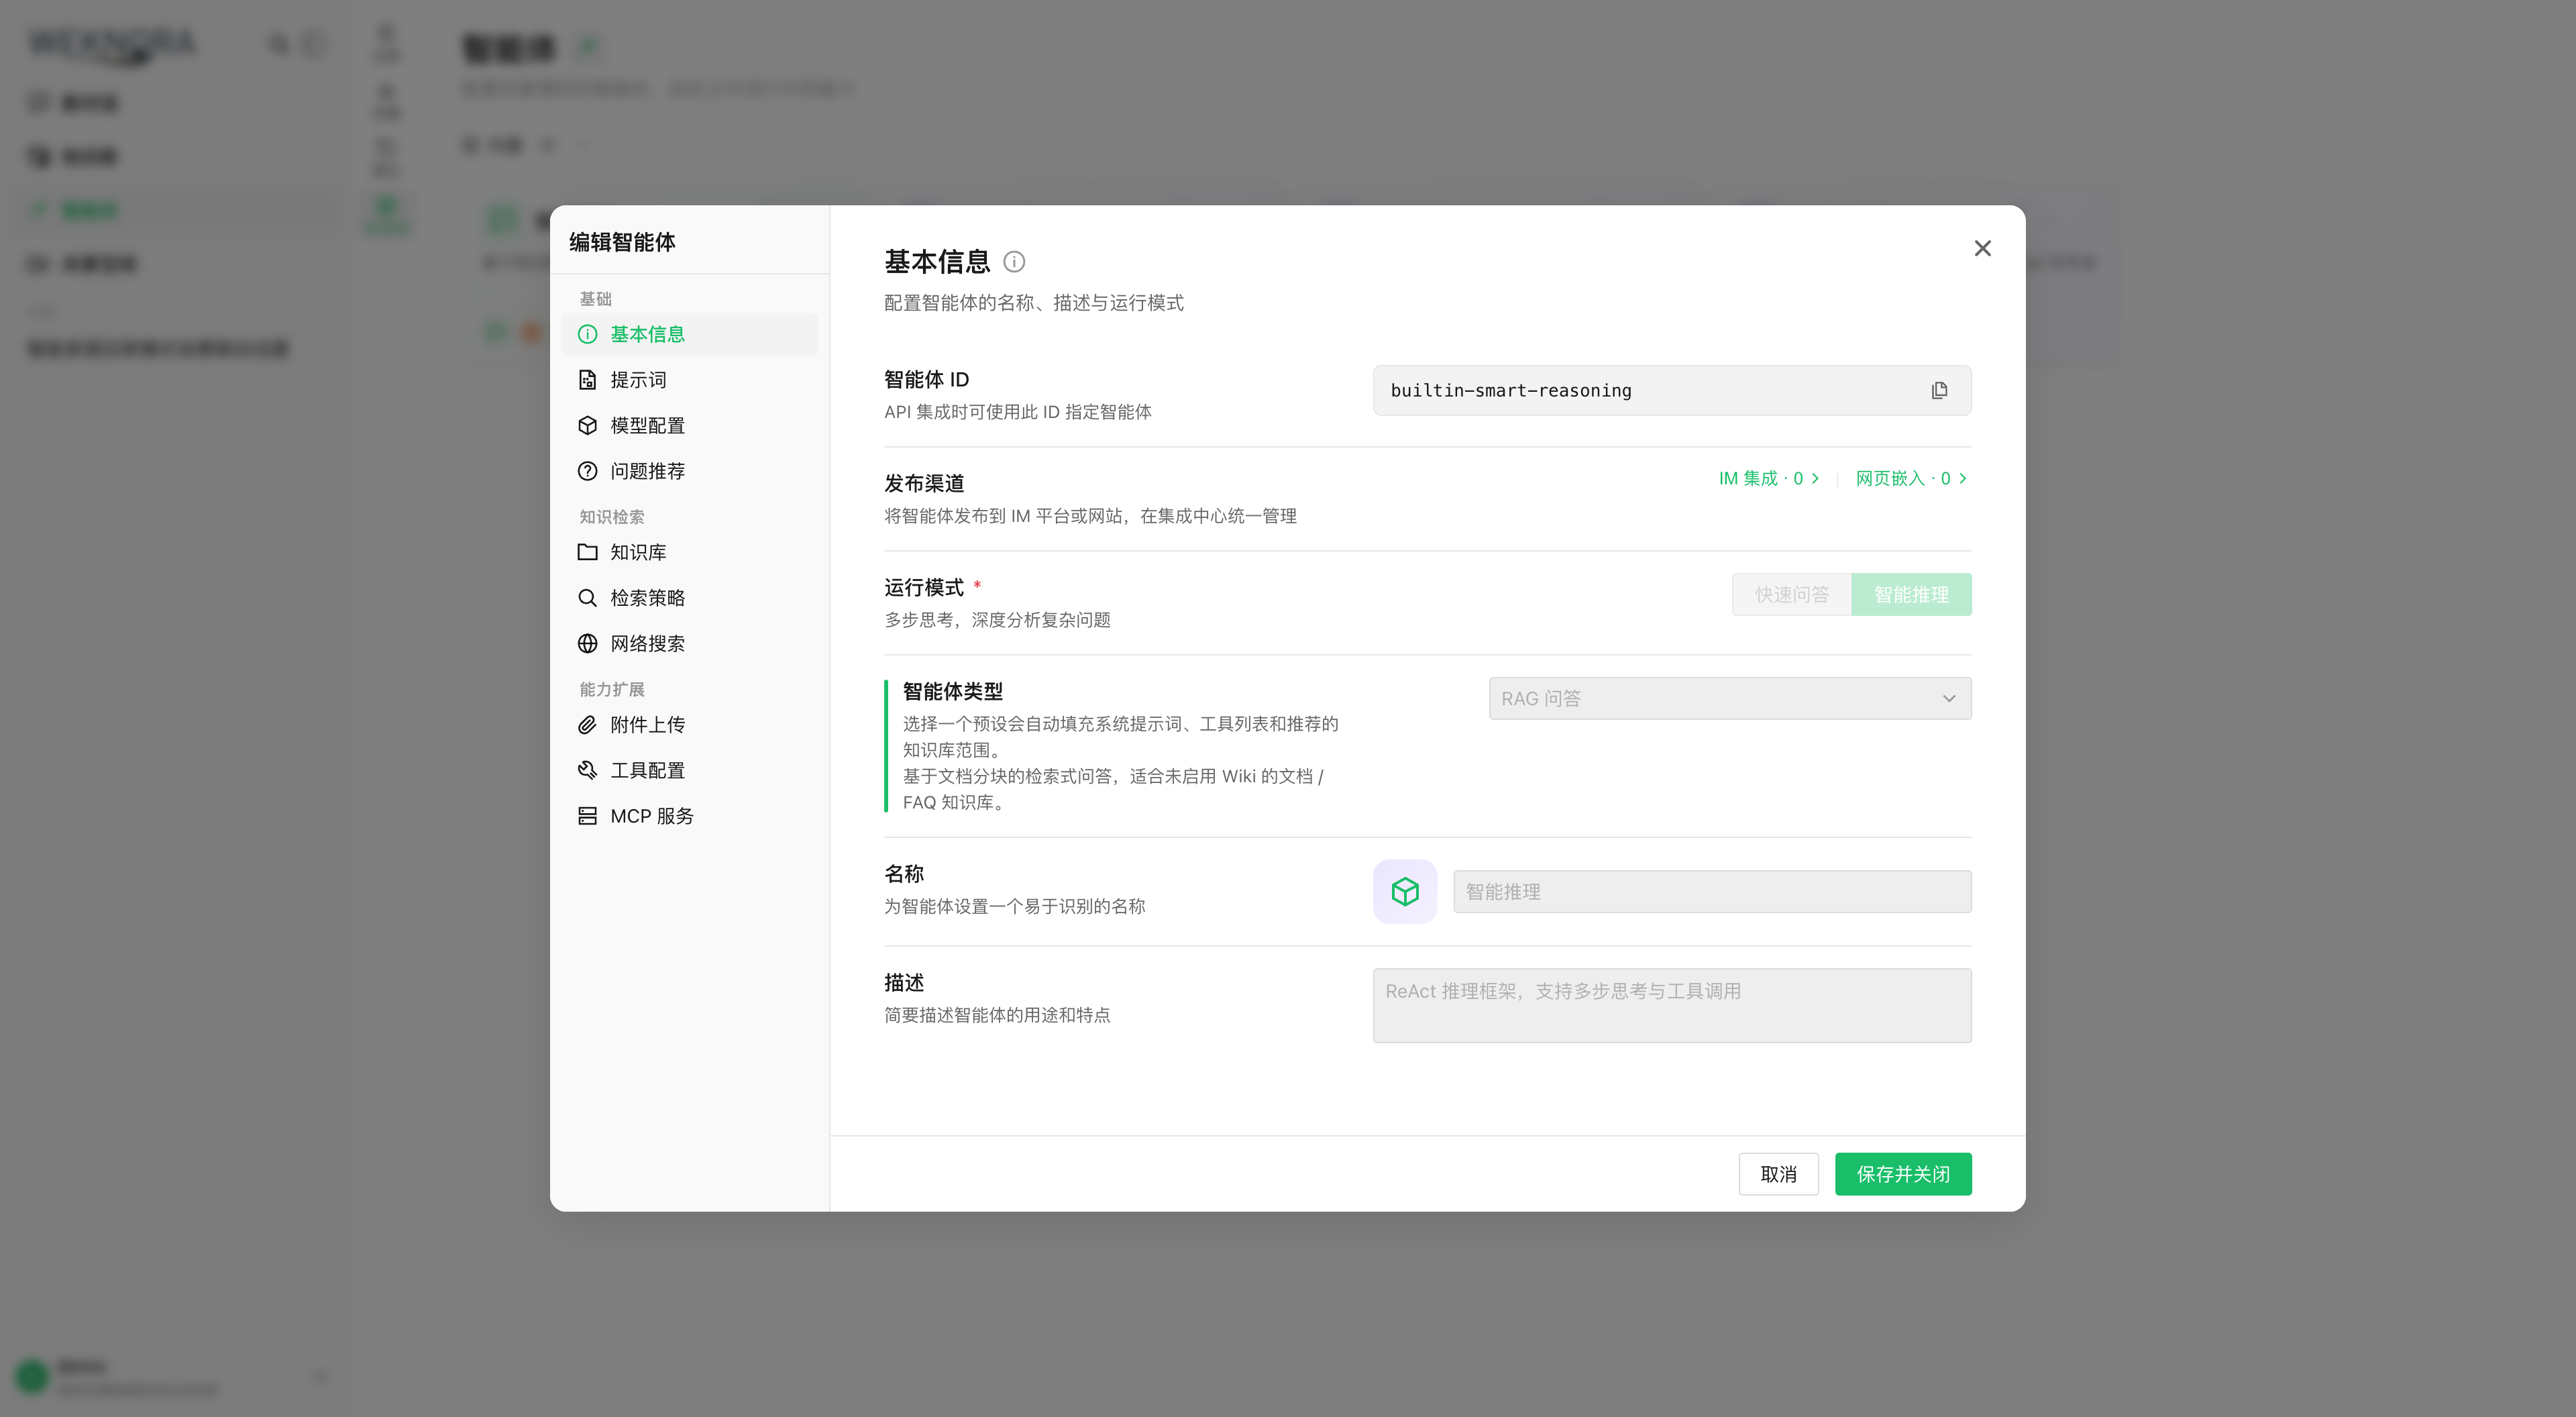
모드 선택, 모델 선택, 지식 베이스 범위, 웹 검색 스위치, MCP 도구 선택이 포함된 Agent 편집 대화상자예요.
website-docs/public/screenshots/agent-editor.png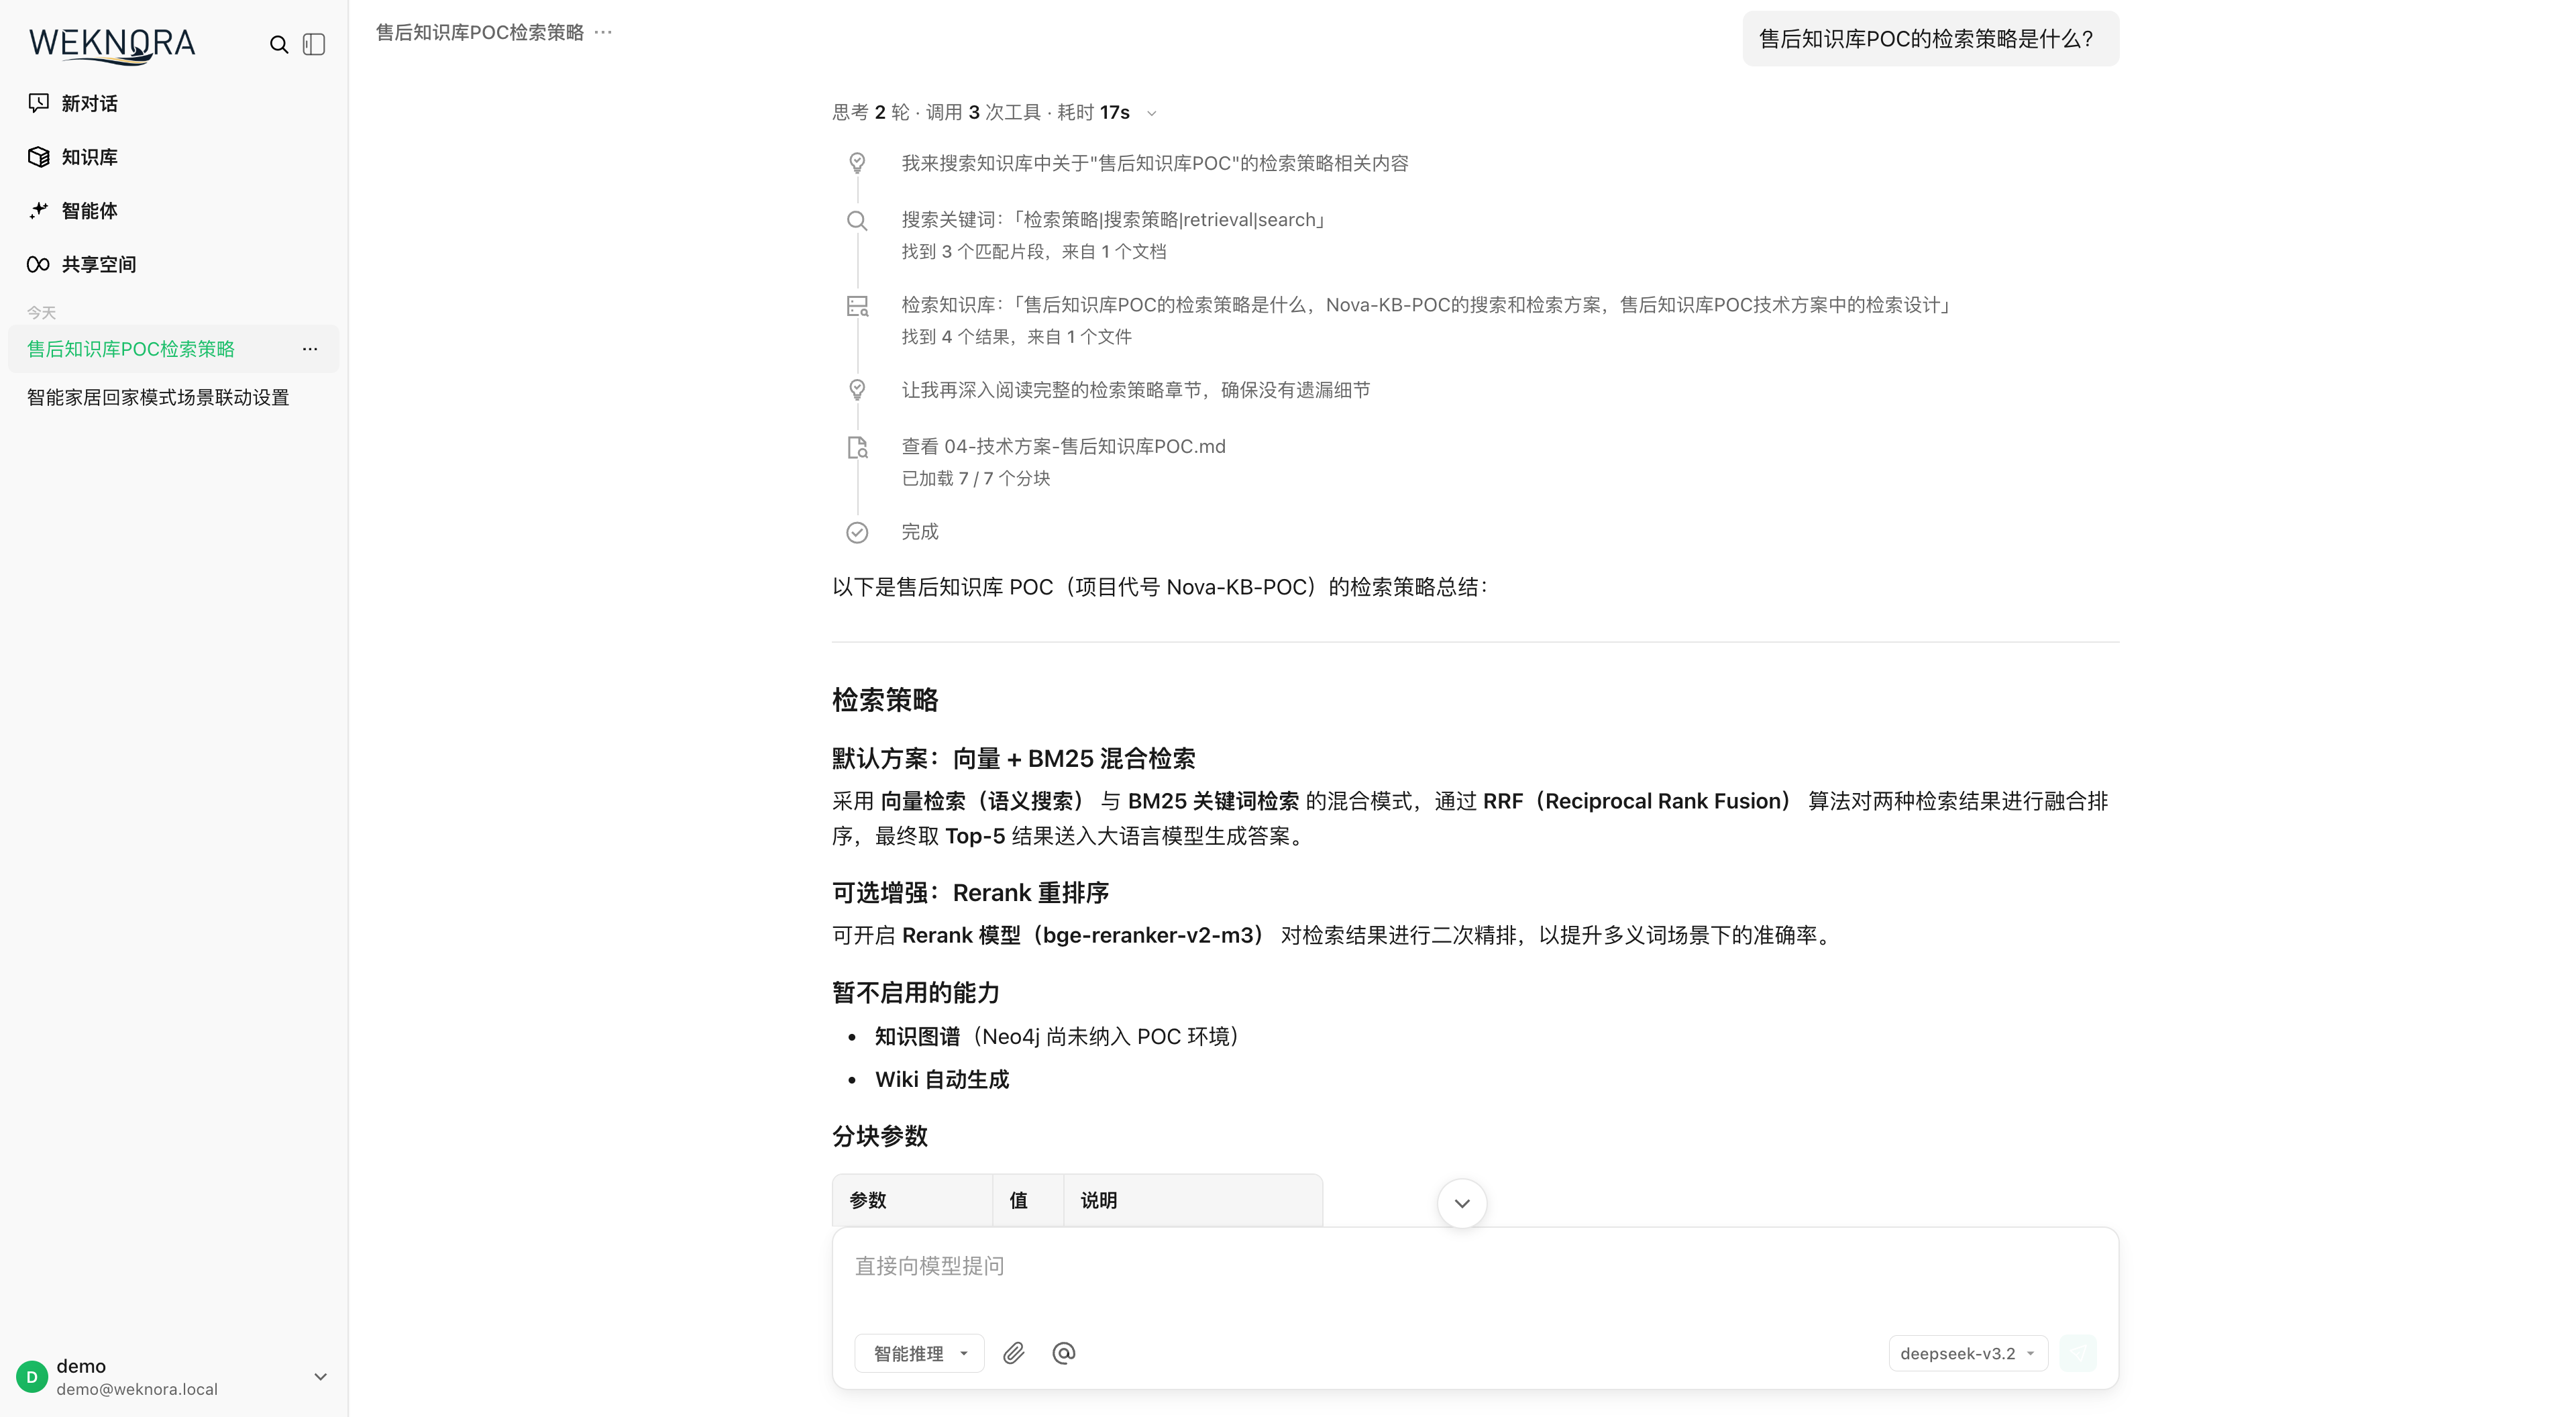
펼친 사고 단계, 도구 호출 카드, 최종 답변의 인용을 포함한 한 차례의 Agent 답변이에요.
website-docs/public/screenshots/agent-chat.png설정은 에이전트가 접근할 수 있는 자료와 도구를 결정하며, 실제 호출에는 현재 사용자 또는 채널의 권한 제한이 적용됩니다.
에이전트 만들기와 사용하기
- 「에이전트」 페이지에서 에이전트를 새로 만들고 빠른 질의응답 또는 지능형 추론 모드를 선택합니다.
- 모델, 지식 베이스 범위, 프롬프트를 선택합니다. 유형 프리셋은 설정을 미리 채우며, 저장하기 전에 조정할 수 있습니다.
- 작업에 따라 웹 검색을 켜거나 MCP 도구를 선택합니다. 스킬 스크립트를 실행하려면 스킬이 설치된 샌드박스도 연결해야 합니다.
- 저장한 뒤 대화 페이지에서 해당 에이전트를 선택해 질문하고 답변 출처와 도구 결과를 확인합니다.
처음 사용할 때는 내장 에이전트를 바로 선택해도 됩니다. 빠른 질의응답은 문서 조회에, 데이터 분석 에이전트는 CSV와 Excel에 적합하며, Wiki 에이전트는 Wiki 콘텐츠 탐색과 유지 관리에 사용합니다.
자료와 도구 범위 설정
에이전트의 지식 베이스 및 스킬 범위는 전체, 지정 항목, 사용 안 함으로 설정할 수 있습니다. 대화의 멘션은 이번 턴의 자료를 선택하거나 우선 사용할 스킬을 알려 주는 용도이며 기존 권한을 우회할 수 없습니다. 웹 검색은 에이전트 설정과 이번 요청의 스위치에 모두 제약을 받습니다.
조직을 통해 에이전트를 공유하면 수신자는 허용된 범위 안에서 원본 공간의 모델과 자료를 사용합니다. 공유 에이전트는 읽기 전용이며 수신자는 설정을 수정할 수 없습니다.
도구 승인과 권한 부여 처리
사람의 승인이 필요한 MCP 도구는 실행 전에 승인 카드를 표시합니다. 사용자는 승인하거나 거부하거나 매개변수를 수정할 수 있습니다. 기본 최대 대기 시간은 10분이며, 거부·시간 초과·취소는 도구 결과로 반환되어 에이전트가 이를 바탕으로 처리를 이어 갈 수 있습니다. 이 승인 메커니즘은 MCP 도구에만 적용됩니다.
MCP 서비스에 OAuth 권한 부여가 필요하면 현재 대화에서 권한을 부여할 수 있습니다. 성공하면 시스템이 도구 호출을 재시도합니다.
스킬, 첨부 파일, 메모리 사용
샌드박스를 연결하면 지능형 추론에서 첨부 파일을 읽고 스크립트를 실행하며 파일을 생성할 수 있습니다. 다운로드할 산출물은 /workspace/output에 기록해야 하며, 답변이 끝나면 세션에서 미리 보고 다운로드할 수 있습니다. 설치와 변수 설정은 스킬 디렉터리와 샌드박스, 첨부 파일 작업은 세션과 대화 경험을 참고하세요.
장기 메모리는 공간과 호출자별로 격리되며, 에이전트별로 메모리 읽기와 쓰기를 끌 수 있습니다. 전체 설명은 세션 간 장기 메모리를 참고하세요.
설정 참고
사용자 지정 Agent
모드와 유형 프리셋
CustomAgent(internal/types/custom_agent.go)에는 두 가지 실행 모드(Config.AgentMode)가 있습니다.
quick-answer: 기존 RAG 파이프라인(검색→컨텍스트 구성→단일 생성)이며 Agent 엔진에 진입하지 않습니다.smart-reasoning: ReAct Agent 모드로,IsAgentMode()가 true를 반환하고MultiTurnEnabled = true를 강제합니다.
smart-reasoning에서는 유형 프리셋(Config.AgentType, config/agent_type_presets.yaml에 정의되며 internal/types/agent_type_preset.go가 로드)도 선택할 수 있습니다. 프리셋은 편집기에서 폼을 미리 채우기만 하며 사용자가 자유롭게 덮어쓸 수 있습니다.
| 프리셋 ID | 시스템 프롬프트 템플릿 | 온도 | 최대 반복 | 미리 선택할 도구 | KB 필터 |
|---|---|---|---|---|---|
rag-qa | progressive_rag_agent | 0.7 | 30 | knowledge_search, grep_chunks, list_knowledge_chunks, get_document_info | 도구에서 파생: any_of vector/keyword |
wiki-qa | wiki_researcher | 0.7 | 30 | wiki_search, wiki_read_page, wiki_read_source_doc, wiki_flag_issue | 도구에서 파생: any_of wiki |
hybrid-rag-wiki | hybrid_rag_wiki_agent | 0.7 | 40 | wiki_search, wiki_read_page, knowledge_search, grep_chunks, list_knowledge_chunks, get_document_info, wiki_flag_issue | any_of vector/keyword/wiki |
data-analysis | data_analyst | 0.3 | 30 | data_schema, data_analysis; 웹 검색 끄기; 파일 형식을 csv/xlsx로 제한 | 명시적 none_of: [faq] |
custom | 없음 | — | — | 미리 채우지 않음 | 제한 없음 |
thinking과 todo_write는 기본 프리셋 도구에 포함되지 않으므로 사용하려면 수동으로 선택해야 합니다. 활성화하면 토큰 비용이 늘어납니다.
설정 항목(CustomAgentConfig)
internal/types/custom_agent.go의 CustomAgentConfig 주요 필드입니다(handler CreateAgent/UpdateAgent가 이 구조를 직접 받습니다).
| 분류 | 필드 | 설명 / 기본값(EnsureDefaults) |
|---|---|---|
| 기본 | agent_mode | quick-answer / smart-reasoning |
| 기본 | agent_type | smart-reasoning의 프리셋 유형. 비어 있거나 알 수 없으면 custom으로 취급 |
| 기본 | system_prompt / system_prompt_id | 직접 입력한 내용 또는 템플릿 ID(시작 시 ResolveBuiltinAgentPromptRefs 등으로 해석) |
| 기본 | context_template / context_template_id | 일반 모드에서 검색 조각을 조합하는 템플릿 |
| 모델 | model_id, rerank_model_id, temperature, max_completion_tokens, thinking, citation_enabled | temperature<0 → 0.7; max_completion_tokens=0이면 런타임 기본값 사용: quick-answer 2048, smart-reasoning 4096, 샌드박스에 연결된 smart-reasoning 24576; thinking 미설정 시 false로 고정; citation 미설정 시 true로 취급 |
| Agent | max_iterations | 기본 10(서비스 계층 상한 100) |
| Agent | llm_call_timeout | 단일 LLM 호출 제한 시간(초). 0이면 전역 기본값(120s) 사용 |
| Agent | allowed_tools | 도구 허용 목록. 비어 있으면 DefaultAllowedTools로 폴백 |
| MCP | mcp_selection_mode(all/selected/none), mcp_services, mcp_auth_wait_timeout | OAuth 대기 시간(초)이 <=0이면 Gate 기본값 사용 |
| 스킬 | skills_selection_mode(all/selected/none), selected_skills, sandbox_config_id | 공간 샌드박스와 설치된 스킬 선택. 스킬 디렉터리와 샌드박스 참고 |
| 메모리 | memory_enabled | nil은 공간 설정 상속, false는 이 에이전트의 메모리 읽기·쓰기 비활성화 |
| 지식 베이스 | kb_selection_mode(all/selected/none), knowledge_bases, retrieve_kb_only_when_mentioned, retain_retrieval_history | retain=true이면 과거 KB 검색 결과를 마스킹하지 않음 |
| 멀티모달 | image_upload_enabled, vlm_model_id, audio_upload_enabled, asr_model_id, image_storage_provider | VLM은 MCP 도구가 반환한 이미지 설명에도 사용 |
| 파일 | supported_file_types, chat_parser_engine_rules, attachment_image_understanding, attachment_ocr_max_pages, attachment_parse_wait_timeout_sec | 데이터 분석형 Agent는 보통 csv/xlsx로 제한 |
| FAQ | faq_priority_enabled, faq_direct_answer_threshold, faq_score_boost | — |
| Web | web_search_enabled, web_search_max_results, web_search_provider_id, web_fetch_enabled, web_fetch_top_n | max_results 기본 5 |
| 멀티턴 | multi_turn_enabled, history_turns | history_turns 기본 5; smart-reasoning은 multi_turn 강제 |
| 검색 | embedding_top_k(10), keyword_threshold(0.3), vector_threshold(0.5), rerank_top_k(5), rerank_threshold | 괄호 안은 기본값 |
| 고급 | enable_query_expansion, enable_rewrite, rewrite_prompt_*, query_understand_model_id, fallback_strategy(기본 model), fallback_response, fallback_prompt, intent_prompts, data_analysis_enabled | 주로 quick-answer 파이프라인에 적용 |
| 추천 | question_suggestions(starters / follow_ups) | starters는 기본 hybrid 모드 6개; follow_ups는 기본 비활성화, 3개 |
Handler 계층(internal/handler/custom_agent.go)은 CreateAgent, GetAgent, ListAgents, UpdateAgent, DeleteAgent, CopyAgent, GetPlaceholders(types.PlaceholdersByField(PromptFieldAgentSystemPrompt)의 플레이스홀더 목록 반환), GetAgentTypePresets(i18n을 포함한 프리셋 목록), GetSuggestedQuestions를 제공합니다. 생성/수정 시 authorizeAgentKnowledgeScope를 통해 제한된 API Key의 KB 범위를 검증합니다. KB가 제한된 key에 kb_selection_mode: all을 지정하면 즉시 403을 반환하고, selected는 하나씩 권한을 검사합니다.
런타임 매핑: buildAgentConfig(session_agent_qa.go)는 CustomAgentConfig를 엔진의 types.AgentConfig(internal/types/agent.go)로 변환하며 다음 조건을 추가합니다. 웹 검색은 Agent와 요청에서 모두 켜져 있어야 합니다(customAgent.Config.WebSearchEnabled && req.WebSearchEnabled). web provider는 테넌트 기본값으로 폴백합니다. SearchTargets는 KB/@문서/@태그 scope에서 통합 구성합니다. MaxContextTokens의 폴백은 200000입니다. @Skill은 턴별 우선 사용 안내를 추가하고 @MCP는 턴별 범위를 좁힙니다(공유 Agent의 @MCP는 Agent의 사전 설정 집합 안에 있어야 합니다). 또한 knowledge_search가 실제 사용 가능할 때만 rerank 모델 설정을 요구합니다(agentRequiresRerankModel).
공유 메커니즘(agent_share)
internal/application/service/agent_share.go: Agent를 **조직(Organization)**에 공유할 수 있습니다.
- Agent 소유 테넌트만 공유할 수 있습니다(
ErrNotAgentOwner). 공유자 소속 테넌트는 조직의 Editor+ 멤버여야 합니다. - 공유 전에 Agent 설정의 완전성을 검증합니다.
model_id가 필수이며, 도구 집합에knowledge_search가 포함되고(또는 도구 집합이 비어 기본 집합으로 폴백하고) KB scope가 비활성화되지 않았다면rerank_model_id도 필수입니다. 그렇지 않으면ErrAgentNotConfigured입니다. - 읽기 전용 권한 강제:
permission = types.OrgRoleViewer(테넌트 간 편집은 v1 범위 밖). 중복 공유는 멱등적으로 갱신합니다. - 수신 테넌트는
TenantDisabledSharedAgentRepository를 통해 특정 공유 Agent를 자신의 테넌트에서 비활성화할 수 있습니다. - 공유 Agent로 대화할 때(
session_agent_qa.go) 검색 및 모델 scope가 Agent 소유 테넌트로 전환됩니다(resolveRetrievalTenantID). 따라서 사용자는 공유자의 KB를 사용할 수 있지만, 사용자 자신의 MCP @멘션은 Agent의 사전 설정 범위로 제한됩니다.
내장 Agent(config/builtin_agents.yaml)
내장 Agent는 config/builtin_agents.yaml에서 정의합니다. 시작 시 types.LoadBuiltinAgentsConfig가 로드하고 BuiltinAgentRegistry(internal/types/builtin_agent_config.go)를 다시 구성합니다. default/zh-CN/zh-TW/ja-JP/ko-KR 다국어 이름과 설명을 지원합니다. system_prompt_id/context_template_id는 시작 시 ResolveBuiltinAgentPromptRefs를 통해 실제 템플릿 내용으로 해석됩니다.
| ID | 이름(zh-CN의 번역) | agent_mode / agent_type | 주요 설정 |
|---|---|---|---|
builtin-quick-answer | 빠른 질의응답 | quick-answer | 템플릿 default_kb + default_context; temperature 0.7; FAQ 우선(직접 답변 임계값 0.9, 가중치 1.2); query expansion + rewrite; 웹 검색 활성화, 5개; Agent 엔진에 진입하지 않음 |
builtin-smart-reasoning | 지능형 추론 | smart-reasoning / rag-qa | max_iterations: 50; 도구: knowledge_search, grep_chunks, list_knowledge_chunks, query_knowledge_graph, get_document_info; 웹 검색 활성화; 멀티턴 5턴 |
builtin-data-analyst | 데이터 분석가 | smart-reasoning / data-analysis | 템플릿 data_analyst; temperature 0.3; max_iterations: 30; 도구는 data_schema + data_analysis만; csv/xlsx로 제한; 웹 검색 비활성화; 이력 10턴 |
builtin-wiki-researcher | Wiki 질의응답 | smart-reasoning / wiki-qa | 템플릿 wiki_researcher; max_iterations: 30; 도구: wiki_search, wiki_read_page, wiki_read_source_doc, wiki_flag_issue(읽기 전용 + 문제 보고); 웹 검색 비활성화 |
builtin-wiki-fixer | Wiki 수정 | smart-reasoning / custom | 템플릿 wiki_fixer; retain_retrieval_history: true(수정하려면 턴을 넘어 페이지 내용을 기억해야 함); 모든 wiki 쓰기 작업 포함(wiki_write_page, wiki_replace_text, wiki_rename_page, wiki_delete_page, wiki_read_issue, wiki_update_issue 등 9개); kb_selection_mode: selected |
추가 사항 두 가지(internal/types/custom_agent.go 기준):
builtin-wiki-fixer는 사용자에게 보이는 Agent 목록에 표시되지 않습니다(builtinAgentIDsOrdered에서 제외). Wiki 편집기가 프로그램으로 호출하는 내부 Agent이지만GetAgentByID로 사용할 수 있습니다.builtinAgentIDsOrdered에는builtin-deep-researcher,builtin-knowledge-graph-expert,builtin-document-assistant등의 ID 상수 순서도 남아 있습니다. 다만 현재 YAML에는 이 항목들이 정의되지 않았으며, 레지스트리는 YAML을 기준으로 합니다.builtin_agents.yaml의 각 항목에는reflection_enabled가 있습니다(데이터 분석가는true, 나머지는false). 하지만 백엔드는 현재 이 필드를 사용하지 않습니다.internal/에는 대응하는 구조체 필드도 참조도 없고 YAML과 프런트엔드 타입 정의에만 존재합니다. 즉, 현재 Agent의 실제 동작에는 영향을 주지 않으며,true라고 해서 반성 단계가 한 차례 추가된다고 해석하면 안 됩니다.
참고로 internal/agent/prompts_wiki.go의 WikiSummaryPrompt, WikiKnowledgeExtractPrompt, WikiTaxonomyPlanPrompt 등의 상수는 Wiki ingest 파이프라인(문서 수집 시 LLM이 wiki 페이지 생성/디렉터리 계획)에 쓰는 프롬프트입니다. wiki 계열 Agent의 런타임 도구와 상호 보완적입니다. 전자는 Wiki 콘텐츠를 만들고 후자는 활용하고 유지 관리합니다.
추천 질문(Starters와 후속 질문)
대화창은 두 곳에서 클릭 가능한 질문을 제공합니다. 세션이 비어 있을 때의 시작 질문(starters), 각 답변이 끝난 뒤의 후속 질문 추천(follow-ups)입니다. 이 설정은 Agent에 속합니다(QuestionSuggestionConfig, internal/types/custom_agent.go). 채널 설정은 표시를 억제할 수만 있고 내용 전략을 바꿀 수는 없습니다.
설정 항목
두 설정 그룹은 각각 독립적으로 켜고 끌 수 있으며, mode가 질문 출처를 결정합니다.
| mode | 출처 |
|---|---|
curated | 사람이 고정 작성한 items만 사용 |
knowledge | 지식 베이스 콘텐츠에서 추출 |
generated | 모델이 생성 |
hybrid(기본) | 위 방식을 혼합 |
| 설정 | 기본값 | 설명 |
|---|---|---|
starters.enabled / mode / items / count | — / hybrid / 비어 있음 / 6 | 시작 질문 |
follow_ups.enabled / mode / count | — / hybrid / 3 | 후속 질문 추천 |
follow_ups.model_id | 비어 있음(세션 모델 사용) | 후속 질문 생성 모델. 소형 모델을 지정해 비용 절감 가능 |
follow_ups.categories | 비어 있음 | 질문 유형 제한: clarify(명확화) / deepen(심화) / action(행동) |
follow_ups.max_context_turns | 2 | 생성 시 되돌아볼 대화 턴 수 |
follow_ups.additional_instruction | 비어 있음 | 생성 프롬프트에 추가할 비즈니스 제약 |
follow_ups.suppress_on_fallback | — | 답변에 폴백 전략이 적용되면 추천하지 않음 |
follow_ups.suppress_when_answer_asks_question | — | 답변 자체가 사용자에게 되묻는 경우 추천하지 않음(두 질문의 충돌 방지) |
follow_ups.knowledge_fallback | — | 생성 실패 시 지식 베이스 출처로 폴백 |
follow_ups.allow_regenerate | — | 사용자의 수동 새 추천 요청 허용 여부 |
생성, 캐시, 이벤트 계측
- 결과는
message_suggestion_sets테이블에 저장하고(assistant_message_id, placement, config_hash, locale)로 캐시합니다.config_hash는 「현재 적용 중인 Agent 설정」의 요약값을 캐시 키에 포함하므로, 설정 변경 시 이전 캐시 대신 자연스럽게 새 추천을 받습니다.locale은 언어별 캐시를 분리합니다. - 상태는
generating→ready이며,suppressed(위 억제 규칙에 따라 건너뜀)와failed도 있습니다.lease_until은 여러 인스턴스가 같은 추천 묶음을 중복 생성하지 않도록 합니다. - API:
GET /sessions/:id/messages/:message_id/suggestions로 조회하고, 같은 경로의POST로 생성을 트리거합니다(멱등).POST /sessions/:session_id/suggestion-events로 계측 이벤트를 보고합니다. - 계측 이벤트:
impression(노출) /click(클릭) /dismiss(닫기) /regenerate(새 추천).message_suggestion_events에 저장합니다. 클릭 후 보내는 다음 사용자 메시지에는SuggestionAttribution(suggestion_set_id+question_id)이 포함되므로 「추천을 클릭한 경우」와 「같은 질문을 직접 입력한 경우」를 통계적으로 구분할 수 있습니다.
실행 메커니즘 참고
개요와 아키텍처
핵심 구성 요소
| 구성 요소 | 소스 위치 | 역할 |
|---|---|---|
AgentEngine | internal/agent/engine.go | ReAct 메인 루프를 구동하며 설정, 도구 레지스트리, Chat 모델, 이벤트 버스 등을 보유 |
ToolRegistry | internal/agent/tools/registry.go | 도구 등록, 조회, 매개변수 검증, 실행, 출력 잘라내기, 리소스 정리 |
| 내장 도구 집합 | internal/agent/tools/*.go | 기능별로 등록된 내장 도구 + 동적 MCP 도구 |
| 토큰 추정과 압축 | internal/agent/token/ + internal/agent/compaction/ | Estimator(BPE 추정)와 긴 대화의 컨텍스트 압축(sandbox 도구 이력) |
| 메모리 통합 | internal/application/service/memory/ | 세션 간 장기 메모리: 추출, 검색, 주제 승격, 문서 친화도, 정리 |
| 스킬 시스템 | internal/agent/skills/ | SKILL.md 탐색, 로드, 스크립트 실행(Progressive Disclosure) |
| 실행 샌드박스 | internal/sandbox/ | 스킬 스크립트와 shell_exec의 Docker / Cube / E2B 세션 단위 격리 실행 및 보안 검증 |
| 도구 승인 | internal/agent/approval/gate.go | 위험한 MCP 도구의 사람 승인(HITL)과 세션 내 OAuth 권한 부여 |
| Agent 서비스 계층 | internal/application/service/agent_service.go | 엔진 조립: 도구 등록, KB 메타정보 해석, 스킬/샌드박스/VLM 초기화 |
| 세션 질의응답 진입점 | internal/application/service/session_agent_qa.go | CustomAgent에서 런타임 AgentConfig 구성 후 실행 |
| 이력 재구성 | internal/application/service/agent_history.go | DB에서 멀티턴 LLM 컨텍스트 재구성(LoadAgentHistory) |
AgentEngine 구조체 정의(internal/agent/engine.go):
type AgentEngine struct {
	config               *types.AgentConfig
	toolRegistry         *agenttools.ToolRegistry
	chatModel            chat.Chat
	eventBus             *event.EventBus
	knowledgeBasesInfo   []*KnowledgeBaseInfo      // 프롬프트용 지식 베이스 상세 정보
	selectedDocs         []*SelectedDocumentInfo   // 사용자가 선택한 문서(@멘션)
	pinnedMCPServices    []*PinnedMCPServiceInfo   // 이번 턴에 사용자가 @멘션한 MCP 서비스
	pinnedSkills         []*PinnedSkillInfo        // 이번 턴에 사용자가 @멘션한 스킬
	sessionID            string
	systemPromptTemplate string
	skillsManager        *skills.Manager           // 점진적 공개를 위한 스킬 관리자(선택 사항)
	appConfig            *appconfig.Config
	imageDescriber       ImageDescriberFunc        // 도구 결과의 이미지를 설명하는 VLM 함수
	tokenEstimator       *agenttoken.Estimator     // 컨텍스트 창 관리용 토큰 추정기
	compactor            *compaction.Compactor // 구조화된 대화 압축
	lastUsage            types.TokenUsage          // 가장 최근 LLM 호출의 토큰 사용량
	lastSentMsgCount     int
	resourceRefs         *llmresource.Registry
	sourceRefs           *llmreference.Registry
}
엔진의 역할과 제약:
- 엔진은 턴 간 상태를 유지하지 않습니다(stateless across turns). 엔진 소스 주석에 명시되어 있듯, 호출자가 매 턴
service.LoadAgentHistory로 DB에서 세션 이력을 재구성하고llmContext로Execute에 전달합니다. 엔진 자체는 캐시, system prompt 저장소, 턴 간 버퍼를 유지하지 않습니다. - 이벤트 기반 출력. 엔진은 SSE를 직접 쓰지 않습니다. 모든 출력(사고, 도구 호출, 도구 결과, 최종 답변, 완료 이벤트)은
event.EventBus로 발행되며, Handler 계층의 구독자가 SSE 스트림으로 변환하고 DB에 저장합니다. 관련 이벤트 타입은EventAgentThought,EventAgentFinalAnswer,EventAgentToolCall,EventAgentToolResult,EventAgentTool,EventAgentComplete,EventError입니다. - 인용/리소스 별칭.
resourceRefs(llmresource.Registry)와sourceRefs(llmreference.Registry)는 각 LLM 호출 전에 메시지를 Encode하여 영구 ID(chunk/document/web의 UUID)를 짧은 별칭(cN/dN/bN/wN,res://NNNN)으로 바꾸고, 스트리밍 반환 시 Decode합니다. 따라서 모델은 실제 UUID를 전혀 보지 못합니다.think.go에는 인코딩 순서를 특별히 명시합니다.resourceRefs를sourceRefs보다 먼저 인코딩해야 합니다. 그렇지 않으면 wiki summary 페이지 slug에 내장된 문서 UUID가 citation 압축에 의해d1같은 별칭으로 잘못 치환되어 끊어진 링크가 생깁니다. - 관측 가능성. 매 실행 시 Langfuse span 계층
agent.execute→agent.round.N→agent.tool.<name>을 시작하며, 반복 차수, 토큰 사용량, 도구 출력 미리보기(4000 rune으로 제한) 등을 포함합니다.database_query의 SQL 매개변수는 Langfuse와 UI hint에서 모두 마스킹됩니다(toolHintSensitiveArgs).
구성 요소 관계도
System Prompt 구성
internal/agent/prompts.go의 BuildSystemPromptWithOptions는 다음 우선순위로 템플릿을 선택합니다.
- Agent에 사용자 지정 system prompt가 설정됨(
AgentConfig.UseCustomSystemPrompt또는 비어 있지 않은SystemPrompt) → 그대로 사용합니다. - 연결된 지식 베이스가 전혀 없음 →
GetPureAgentSystemPrompt(config/prompt_templates/agent_system_prompt.yaml에서 mode가pure인 템플릿). - 그 외 →
GetProgressiveRAGSystemPrompt(mode가rag인 템플릿).
템플릿이 지원하는 플레이스홀더(renderPromptPlaceholdersWithStatus):
| 플레이스홀더 | 확장 결과 |
|---|---|
| 레거시 플레이스홀더. 현재는 <runtime_context> 안의 <bound_knowledge_bases>를 가리키는 안내 문장으로 확장(KB 상세 정보는 사용자 메시지로 이동) |
| Enabled / Disabled |
| RFC3339 형식의 현재 시각 |
| 사용자 언어 이름(예: "Chinese (Simplified)") |
| 비움. 스킬 메타데이터는 formatSkillsMetadata가 별도로 추가 |
스킬을 활성화하면 formatSkillsMetadata가 system prompt 끝에 "Available Skills" 단락(Level 1 메타데이터 + 필수 Skill Matching Protocol)을 추가하고, read_file로 스킬 리소스를 읽고 shell_exec로 스킬 명령을 실행하는 방법을 설명합니다.
런타임 컨텍스트(runtime_context): system prompt와 달리 연결된 KB의 전체 상세 정보(capabilities, 최근 문서/FAQ 목록), @멘션으로 고정한 문서(pinned_documents), 현재 시각, 세션 ID는 XML 블록 <runtime_context scope="this_turn">으로 현재 턴 사용자 메시지에 주입됩니다(internal/agent/observe.go의 buildRuntimeContextBlock). 오래된 scope가 후속 턴에 영향을 주지 않도록 이력에는 영구 저장하지 않습니다. 블록에는 다음 두 지침도 항상 포함됩니다.
<communication_instruction>: 답변/사고에 내부 도구 이름과 내부 ID가 나오지 않도록 합니다(grep_chunks등이 아니라 "키워드 검색"이라고 표현하도록 요구).<answer_instruction>: 정보가 충분해지면 일반 텍스트로 완전한 답변을 작성하고 중단하도록 합니다(추가 도구 호출 금지). 이것이 Agent의 종료 프로토콜입니다.
사용자가 MCP 서비스나 스킬을 @멘션하면 buildMustUseBlock이 <must_use> 블록을 추가로 주입하여 해당 접두사의 MCP 도구를 사용하거나 먼저 read_file로 스킬 설명을 읽도록 강제합니다.
ReAct 루프 단계별 상세 설명
진입점: Execute
AgentEngine.Execute(internal/agent/engine.go)의 흐름:
defer e.toolRegistry.Cleanup(ctx)— 실행이 끝날 때types.Cleanable을 구현한 도구를 정리합니다(예:data_analysis는 이 세션에서 만든 DuckDB 테이블을 DROP).- Langfuse
agent.executespan을 시작합니다. types.AgentState를 초기화합니다(RoundSteps,KnowledgeRefs,IsComplete=false,CurrentRound=0).buildSystemPrompt+buildMessagesWithLLMContext(system + 이력 + 현재 사용자 메시지, 이미지 URL 포함).buildToolsForLLM이 레지스트리의 도구를 function calling 정의로 변환합니다.executeLoop에 진입합니다.
메인 루프: executeLoop와 runReActIteration
for state.CurrentRound < e.config.MaxIterations {
    // ctx 취소 확인 → 도구 결과가 이미 있으면 최종 답변을 구제 합성
    outcome, iterErr := e.runReActIteration(...)
    switch outcome {
    case iterOutcomeContinue: continue loop   // 빈 응답 재시도, 반복 횟수 소모 없음
    case iterOutcomeBreak:    break loop      // 종료(자연 종료/정체/취소/콘텐츠 필터링)
    case iterOutcomeNext:     state.CurrentRound++
    }
}
if !state.IsComplete && ctx.Err() == nil {
    e.handleMaxIterations(ctx, query, state, sessionID) // 폴백으로 최종 답변 합성
}executeLoop는 defer emitCompletion()으로 모든 종료 경로에서 정확히 한 번 EventAgentComplete를 발행하도록 보장합니다(context.WithoutCancel을 사용해 사용자가 "중지"를 눌러도 이벤트가 전달됨). 이 이벤트는 state.RoundSteps를 포함하며, stream handler가 assistant 메시지의 AgentSteps 필드에 기록해 영구 저장합니다.
한 번의 runReActIteration은 내부적으로 다음 네 단계를 순서대로 진행합니다.
① Think(사고): 먼저 컨텍스트 창을 관리한 뒤(메모리와 컨텍스트 압축 참고) callLLMWithRetry(internal/agent/think.go)를 호출합니다.
agenttools.SanitizeMessages가 같은 역할의 연속 메시지, 대응 호출이 없는 tool result 등의 문제를 수정합니다.- LLM을 스트리밍 호출합니다(
streamThinkingToEventBus). 단일 호출 제한 시간은defaultLLMCallTimeout = 120s이며AgentConfig.LLMCallTimeout으로 덮어쓸 수 있습니다. - 일시적 오류(429/5xx/timeout/overloaded 등,
transientErrorMarkers참고)는 최대maxLLMRetries = 2회 재시도하며, 백오프는 1s, 2s입니다. - 재시도도 실패했지만 앞선 도구 결과가 있으면 점진적 기능 저하 경로를 사용합니다.
streamFinalAnswerToEventBus가 기존 도구 결과로 최종 답변을 합성하고state.IsComplete = true로 설정합니다.
스트리밍 중 reasoning_content 채널(DeepSeek 등)과 내장 <think> 블록(ThinkStreamSplitter가 분리)은 모두 "사고" 영역(EventAgentThought)으로 라우팅됩니다. 일반 content는 우선 최종 답변 영역(EventAgentFinalAnswer)으로 바로 스트리밍됩니다. 이후 이번 반복에서 도구 호출이 발생하면 UI가 이 텍스트를 preamble로 간주해 단계 트리로 옮기고 해당 반복의 Thought로도 유지합니다.
② Analyze(판정): analyzeResponse(internal/agent/observe.go)가 종료 조건을 확인합니다.
finish_reason == "content_filter"이고 도구 호출이 없음 → 종료하며, 답변은 필터링된 콘텐츠 또는 고정된 사과 문구입니다.- 자연 종료(
isNaturalStopFinishReason:stop/end_turn/stop_sequence)이고 도구 호출이 없음 → Agent 종료. 일반 텍스트 응답이 최종 답변입니다(별도 final_answer 도구는 없습니다. 과거 데이터에 남은final_answer도구 호출은 재생 시filterNonTerminalToolCalls가 걸러 냅니다). - 자연 종료지만 내용이 비어 있음 → nudge 사용자 메시지
"Please provide your complete answer now as plain text."를 추가해 최대maxEmptyResponseRetries = 2회 재시도합니다(iterOutcomeContinue를 반환하며 반복 횟수를 소모하지 않음). 재시도를 소진하면 고정 fallback 문구로 종료합니다.
Analyze 전에 정체 감지도 수행합니다. 연속 maxRepeatedResponseRounds = 2회 완전히 같은 내용이 반환되고 도구 호출이 없으면(대개 처리하지 않은 finish reason 때문), 강제 종료하고 그 내용을 최종 답변으로 사용합니다.
③ Act(행동): executeToolCalls(internal/agent/act.go)가 이번 반복의 모든 도구 호출을 실행합니다.
AgentConfig.ParallelToolCalls == true이고 호출 수가 ≥ 2이면errgroup으로 병렬 실행합니다(best-effort, 하나가 실패해도 다른 작업을 취소하지 않음). 결과는 원래 순서대로 채웁니다.- 각 호출에서 먼저
NormalizeToolCallID를 수행하고 JSON 매개변수를 파싱합니다. 파싱 실패 시RepairJSON으로 복구한 뒤 다시 시도합니다. 여전히 실패하면 안내가 포함된 오류 결과("[Analyze the error above and try a different approach.]")를 반환해 전체 반복을 실패시키는 대신 모델이 다른 방법을 찾게 합니다. - 단일 도구 실행 제한 시간은
defaultToolExecTimeout = 60s입니다.ToolExecContext에는 이 제한 시간이 적용되지 않는ApprovalCtx도 포함되어, MCP 사람 승인/OAuth처럼 정상적으로 오래 기다려야 하는 작업에 사용합니다. EventAgentToolCall(중국어 display name의 hint 포함, 예:웹 검색("...")),EventAgentToolResult,EventAgentTool이벤트를 발행합니다.
④ Observe(관찰): appendToolResults(internal/agent/observe.go)가 OpenAI 프로토콜에 따라 이번 반복을 메시지 배열에 추가합니다. tool_calls가 있는 assistant 메시지 하나와 결과별 role:"tool" 메시지 하나씩입니다(내용은 sourceRefs.ModelOutput으로 별칭 처리). 이번 반복의 성공한 도구 결과 중 Markdown 이미지가 하나라도 있으면 system 메시지에 ## Retrieved Image Output Requirement 요구 사항(internal/agent/image_requirement.go)을 한 번 추가해 최종 답변에 관련 이미지를 원형 그대로 포함하도록 강제합니다. 이후 state.CurrentRound++로 다음 반복에 진입합니다.
종료 조건 요약과 최대 반복
| 종료 경로 | 트리거 조건 | 최종 답변 출처 |
|---|---|---|
| 자연 종료 | finish_reason ∈ {stop, end_turn, stop_sequence}이며 도구 호출이 없고 내용이 비어 있지 않음 | 해당 반복의 일반 텍스트 응답 |
| 빈 응답 재시도 소진 | 자연 종료지만 내용이 비어 있고 nudge 재시도 2회 후에도 비어 있음 | 고정 fallback 문구 |
| 콘텐츠 필터링 | finish_reason == content_filter이며 도구 호출 없음 | 필터링된 내용 또는 안전 안내 |
| 정체 감지 | 연속 2회 같은 내용이며 도구 호출 없음 | 반복된 내용 자체 |
| 사용자 취소 / 시간 초과 | ctx.Done(); 도구 결과가 있으면 구제 합성 | 합성 답변 또는 일부 단계 유지 |
| 복구 불가능한 LLM 실패 | 재시도 소진; 도구 결과가 있으면 → 축소 합성, 없으면 오류 | 합성 답변 / 오류 이벤트 |
| 최대 반복 도달 | CurrentRound == MaxIterations | handleMaxIterations → streamFinalAnswerToEventBus 합성 |
최대 반복 횟수의 계층별 기본값:
- 엔진 기본값:
DefaultAgentMaxIterations = 20(internal/agent/const.go). - 서비스 계층
ValidateConfig:<= 0이면 5로 폴백하고, 절대 상한은MAX_ITERATIONS = 100(internal/application/service/agent_service.go). CustomAgent.EnsureDefaults: 미설정 시 10(internal/types/custom_agent.go).- 내장 Agent: 지능형 추론 50, 데이터 분석가 30, Wiki 질의응답/수정 30(
config/builtin_agents.yaml).
상한에 도달하면 handleMaxIterations는 전용 합성 prompt(internal/agent/finalize.go)를 사용해 모든 도구 결과를 user 메시지로 LLM에 전달하고 완전한 답변을 생성합니다(합성 단계에서는 thinking 비활성화). 검색 결과에 Markdown 이미지가 있으면 이미지 출력 요구 사항도 추가합니다.
ReAct 루프 흐름도
내장 도구 상세 안내
전체 도구 표
도구 이름 상수는 internal/agent/tools/definitions.go에 정의되어 있습니다. 아래 표는 모든 내장 도구를 포함합니다(매개변수 열은 schema 필드만 나열하며 *는 필수).
| 도구 이름 | 주요 매개변수 | 동작 / 반환 |
|---|---|---|
thinking | thought*, next_thought_needed*, thought_number*, total_thoughts*, is_revision, revises_thought, branch_from_thought, branch_id, needs_more_thoughts | Sequential Thinking: 사고 단계 기록/수정/분기; 사고 진행 상황(incomplete_steps 포함) 반환. 사고에 도구 이름과 최종 답변을 포함하지 않도록 안내 |
todo_write | task, steps[]*(id/description/status: pending/in_progress/completed) | 검색 작업 계획 생성/갱신. 검색 작업 전용(요약은 thinking 담당); 서식화된 계획 반환, display_type: "plan" |
knowledge_search | queries[]*(의미 기반 질문 1–5개), knowledge_base_ids[] | 의미/벡터 검색, 선택적 rerank; 기본 topK=5, vector 임계값 0.6, keyword 임계값 0.5. minScore는 여전히 전달할 수 있고 기본 0.3이지만 후처리 필터는 생략됩니다. HybridSearch가 RRF 융합을 사용한 뒤 점수 범위가 [0, ~0.033]이 되어 기존 [0,1] 임계값이 더는 적합하지 않기 때문입니다. 임계값 필터링은 RRF 전에 각 엔진에서 완료하며 리랭킹 단계에는 별도의 rerankThreshold()(전역 설정 우선)가 있습니다. 결과에는 짧은 ID cN/dN이 포함되며 세션에서 이미 본 chunk는 중복 제거·압축 |
grep_chunks | query*(단일 POSIX 정규식, | 선택 지원) | DB에서 대소문자 무시 정규식 매칭(PostgreSQL ~* / MySQL REGEXP); 최대 30개, >10개이면 MMR(λ=0.7)로 중복 축소; <match> 조각과 문서별 집계 요약(최대 20행) 반환; 이미 본 chunk는 already_seen 표시 |
list_knowledge_chunks | faq_id / chunk_id / knowledge_id(셋 중 하나), limit(기본 20, 상한 100), offset | 단일 FAQ/chunk 읽기 또는 문서의 모든 청크를 페이지별 탐색; KB가 searchTargets 및 @mention 범위 안인지 검증 |
query_knowledge_graph | knowledge_base_ids[]*(bN 1–10개), query* | 각 KB 지식 그래프의 엔터티와 관계를 동시에 조회; 그래프가 설정되지 않은 KB는 일반 검색 결과로 폴백 |
get_document_info | knowledge_ids[](dN), faq_ids[](cN)(최소 하나) | 문서 메타데이터(제목, 유형, 크기, parse_status, 청크 수) 또는 FAQ 표준 질문/답변을 병렬 일괄 반환 |
database_query | SQL(SELECT-only) | 허용 목록 테이블(knowledge_bases/knowledges/chunks)을 읽기 전용 조회. tenant_id 필터와 deleted_at IS NULL 자동 주입; UI/Langfuse에서 SQL 매개변수 마스킹 |
data_schema | knowledge_id*(dN) | CSV/Excel 파일의 table_summary + table_column 유형 청크를 읽어 테이블 이름, 열 정보, 행 수 반환 |
data_analysis | knowledge_id*, sql* | CSV/Excel을 DuckDB에 로드한 뒤 SQL 실행; 여러 Sheet의 Excel을 한 테이블로 합치고 __sheet_name 열 제공; 열 이름의 대소문자/공백 차이 자동 수정; 세션 종료 Cleanup 시 생성한 테이블 DROP |
web_search | query*, 선택 사항 count, country, freshness, content | 웹 검색. 제공업체의 제목, 요약, 짧은 페이지 ID wN을 직접 반환; 작업에 따라 지식 베이스 또는 웹 검색 선택. Agent 검색은 더 이상 RAG 압축을 자동 수행하지 않음; Brave는 지역/최신성 필터 지원. content=true이면 상위 3개 본문을 병렬 가져오고 전체 본문 주소 반환 |
web_fetch | items[]*(각 항목의 url*=wN 또는 HTTP(S) URL, 선택 사항 offset, limit) | 최대 8개 웹페이지 동시 가져오기(SSRF 보안 클라이언트 + DNS pinning, 필요 시 chromedp 렌더링), Markdown 또는 지원하는 텍스트 본문 직접 반환; 60s 제한. 문자 단위 페이지 처리, next_offset으로 이어 읽기; 전체 본문은 full_output_path에 저장하며 read_file로 턴 간 행 단위 읽기 가능. URL별 success/failed/skipped 상태와 재시도 가능한 오류 코드 반환. 일부 실패가 다른 페이지에 영향을 주지 않음 |
read_file | path, offset, limit, max_bytes; 웹페이지는 line_offset 추가 가능 | 작업 공간 텍스트, skill:// 리소스, web:// 웹페이지 스냅샷을 읽고 결과에 따라 이어 읽기 |
shell_exec | command; skill_name, work_dir, timeout_sec, max_output_bytes, max_stderr_bytes, env | 현재 세션 샌드박스에서 명령 실행. 스킬 지정 시 스킬 디렉터리와 변수 해석 |
list_sandbox_files | 경로 등 | 샌드박스 파일과 사용 가능한 산출물 탐색 |
write_sandbox_file | path, content, mode | 작업 공간 파일 쓰기 또는 덧붙이기 |
edit_sandbox_file | path, edits | 원본 버전을 기준으로 일괄 정밀 치환 |
search_memory | query, limit | 현재 호출자 범위에서 장기 메모리 조회 |
search_conversations | 쿼리와 범위 | 현재 호출자가 사용할 수 있는 과거 대화 검색 |
wiki_search | queries[]*(정규식), limit(기본 10), knowledge_base_id | Wiki 페이지(제목/내용/slug/요약)에서 POSIX 정규식 검색. bN 표시가 있는 페이지와 요약 반환; 이미 본 slug 중복 제거 |
wiki_read_page | slugs[]*, knowledge_base_id | slug로 Wiki 페이지 전문, 메타데이터, 인바운드/아웃바운드 링크 읽기(링크에 요약 첨부, 이미 본 것은 생략); index slug는 유형별 디렉터리 개요 반환(유형별 top 20) |
wiki_read_source_doc | knowledge_id*(dN), query(정규식), start_chunk_index, end_chunk_index | Wiki 페이지의 원본 문서 상세 읽기: 정규식 필터 또는 chunk 구간별 연속 내용 조회. 둘 다 전달하지 않으면 문서 시작 부분 반환 |
wiki_write_page | slug*, title*, summary*, content*, page_type*, aliases[], source_refs[] | Wiki 페이지 생성 또는 전체 덮어쓰기; 쓰기 전에 slug 정규화·검증; 아웃바운드 링크 자동 처리 |
wiki_replace_text | slug*, old_text*, new_text*, source_refs[] | 정확한 텍스트 치환. 소규모 수정에 적합 |
wiki_rename_page | slug*, new_slug* | slug 이름 변경 후 이를 참조하는 모든 페이지 링크를 연쇄 갱신 |
wiki_delete_page | slug* | 페이지 삭제 후 다른 페이지의 인바운드 링크를 자동 정리해 끊어진 링크 방지 |
wiki_flag_issue | slug*, issue_type*(mixed_entities/contradictory_facts/out_of_date/other), description*, suspected_knowledge_ids[] | 페이지의 사실 오류/엔터티 혼동 등을 표시하고 수동 또는 자동 유지 관리를 위한 issue 기록 |
wiki_read_issue | issue_id / slug | 특정 issue 상세 조회 또는 특정 페이지의 pending issue 목록 조회 |
wiki_update_issue | issue_id*, status*(resolved/ignored/pending) | issue 상태 갱신 |
mcp_{service}_{tool}(동적) | MCP 서비스의 InputSchema에 따라 결정 | 외부 MCP 도구 래핑. 설명 접두사 [MCP Service: X (external)]로 신뢰할 수 없는 출처임을 안내; 사람 승인 및 세션 내 OAuth 연결 가능 |
기본 도구 허용 목록 DefaultAllowedTools()(기존 Agent에 allowed_tools가 없을 때의 폴백): thinking, todo_write, knowledge_search, grep_chunks, list_knowledge_chunks, query_knowledge_graph, get_document_info, database_query, data_analysis, data_schema.
도구 레지스트리(ToolRegistry)
internal/agent/tools/registry.go:
- 등록:
RegisterTool은 first-wins 전략을 사용합니다. 같은 이름으로 나중에 등록하는 도구를 거부하여 MCP 서비스가 이름 충돌로 내장 도구를 탈취하지 못하게 합니다(보안 공지 GHSA-67q9-58vj-32qx 관련). - 정의 내보내기:
GetFunctionDefinitions는 도구 이름순으로 정렬해 LLM에 보내는 tools 페이로드가 요청 간 바이트 단위로 같도록 보장합니다. 이를 통해 접두사 일치에 의존하는 provider prompt cache(예: Qwen 명시적 캐시)를 활용합니다. - 실행 파이프라인:
ExecuteTool=CastParams(LLM의 흔한 타입 편차, 예:"true"를true로 변환) →ValidateParams(JSON Schema 사전 검증으로 잘못된 실행 및 LLM 왕복 한 번 절약) →tool.Execute→ 출력 잘라내기. - 출력 잘라내기:
TruncateToolOutput(truncate.go)의 기본 상한은DefaultMaxToolOutput = 16000rune입니다(AgentConfig.MaxToolOutputChars로 변경 가능). 초과 시 앞 70% + 뒤 30%를 남기고 중간에 잘림 표시를 삽입해 큰 결과가 컨텍스트를 오염시키지 않도록 합니다. - 오류 안내: 실패 결과에는 일관되게
"[Analyze the error above and try a different approach.]"를 추가해 LLM이 전략을 바꾸도록 유도합니다. - 정리:
Cleanup이types.Cleanable을 구현한 도구를 순회하며 리소스를 해제합니다.
기능(capabilities) 메커니즘과 설정별 활성화
internal/agent/tools/capabilities.go는 프런트엔드 frontend/src/utils/tool-capabilities.ts의 Go 대응 구현이며, 각 도구가 요구하는 KB 기능을 선언합니다.
var ToolCapabilityRequirements = map[string]ToolRequirement{
	"thinking":   {},
	"todo_write": {},
	"knowledge_search":      {AnyOf: []KBCapability{CapVector, CapKeyword}, ConsumesFiles: true},
	"grep_chunks":           {AnyOf: []KBCapability{CapVector, CapKeyword}, ConsumesFiles: true},
	// ...
	"wiki_search":          {AllOf: []KBCapability{CapWiki}},
	// ...
	"data_analysis": {AnyOf: []KBCapability{CapVector, CapKeyword}, ConsumesFiles: true},
}
기능 열거값은 vector / keyword / wiki / graph / faq입니다. 여기서 다음이 파생됩니다.
DeriveKBFilterForAgent(agentMode, allowedTools): Agent 편집기/@메뉴에서 선택 가능한 KB의 필터 조건.quick-answer모드는 암묵적으로vector|keyword를 요구합니다.KBSatisfiesToolRequirements: 백엔드의 마지막 방어선. 프런트엔드를 우회하는 클라이언트도 호환되지 않는 KB를 도구에 전달할 수 없습니다.ToolsConsumeFiles: 채팅 입력창에@file목록을 표시할지 결정합니다.
런타임 활성화 로직(agent_service.go의 registerTools)은 "필터링만 하고 주입하지 않는다"는 원칙을 따릅니다.
- 시작점은
config.AllowedTools입니다(사용자가 편집하는 허용 목록이며 preset은 초기 채우기만 수행). 비어 있으면DefaultAllowedTools()로 폴백합니다. - 이번 턴에 지식 검색 scope가 전혀 없으면(Pure Agent 모드) 모든 KB/Wiki/데이터 도구를 걸러 냅니다. 웹 검색도 꺼져 있다면
todo_write까지 제거합니다. WebSearchEnabled이면web_search+web_fetch를 자동 추가합니다.- 강제 안전장치:
SearchTargets의 각 KB 실제 기능을 검사합니다. wiki KB가 없으면 모든 wiki 도구를 제거하고, vector/keyword KB가 없으면 모든 RAG 도구를 제거합니다(먼저 wiki 도구를 선택한 뒤 non-wiki KB로 바꾸는 등 오래된 설정 방지). - 중복 제거 후 하나씩 인스턴스화하고 등록합니다. MCP 도구는
MCPSelectionMode(all/selected/none)에 따라 별도로 등록합니다. 샌드박스 shell/파일 도구는 세션 기능에 따라 등록하며read_file에는 스킬 및 웹페이지 데이터 소스가 추가됩니다. 기존 스킬 도구 이름은 호환성 식별에만 사용하며 더 이상 등록하지 않습니다.
메모리와 컨텍스트 압축
장기 메모리는 공간과 호출자별로 세션을 넘어 저장하며, 아래의 세션 이력 압축과 별도로 설정합니다. 활성화 및 개인 관리는 세션 간 장기 메모리, 전체 API는 메모리 API를 참고하세요.
토큰 예산과 추정기
- 컨텍스트 예산:
AgentConfig.MaxContextTokens.buildAgentConfig에서 미설정이면types.DefaultMaxContextTokens = 200000으로 폴백합니다. token.Estimator(internal/agent/token/estimator.go)는 tiktoken의 cl100k_base 인코딩으로 추정하며, 상수는perMessageOverhead = 3,perConversationTail = 3입니다. 인코딩 실패 시len(s)/4근사값으로 폴백합니다.- 실측값 우선: 실제 토큰 수는 모델 API가 반환한
Usage를 기준으로 합니다. 엔진의estimateCurrentTokens는 이전 반복에서 API가 보고한lastUsage.TotalTokens를 기준선으로 삼고, 새 메시지(assistant 응답 + tool 결과)에 대해서만 BPE 증분 추정을 수행합니다. 첫 반복에 Usage가 없을 때만 전체 추정을 합니다.
컨텍스트 압축과 초과 복구
manageContextWindow(internal/agent/observe.go)는 매 Think 전에 compaction.Compactor를 호출합니다. MaxContextTokens는 에이전트 설정을 우선하고, 다음으로 모델 parameters.context_window를 사용하며, 마지막으로 200000에 폴백합니다. 트리거 임계값은 창 크기에서 reserve를 뺀 값입니다. reserve는 최소 16384이며 이번 반복의 출력 예산에 따라 증가합니다: max(completion 예산 + 4096, 16384).
압축은 토큰 예산에 따라 보존할 최근 메시지를 선택합니다. 기본 KeepRecentTokens=20000이며 작은 창에서는 사용 가능한 창의 4분의 1로 낮춥니다. 긴 ReAct 세션은 현재 턴 내부에서 나눌 수 있습니다. 분할 지점은 assistant 도구 호출과 그 tool 결과를 분리하지 않으며, 분할된 턴의 앞부분을 별도로 요약해 보존한 뒷부분을 설명합니다.
이전 요약도 갱신에 참여하며 오래된 이력은 구조화된 요약으로 만듭니다. 결과는 표시가 있는 user 메시지로 system과 보존된 끝부분 사이에 넣습니다. 요약 예산은 reserve, 모델 출력 상한, 보존 예산에서 계산하며 더 이상 2000으로 고정하지 않습니다. 각 요약은 최대 2회, 매회 60초 동안 시도합니다. 실패하면 원문 아카이브로 폴백하고 degraded로 표시합니다.
internal/agent/compaction/fileops.go는 압축 대상 메시지에서 파일 읽기·쓰기 경로를 기계적으로 추출하고 이전 요약의 파일 목록을 상속하여 모델이 이미 저장한 산출물을 잊지 않게 합니다. 일반 읽기에는 read_file을 사용하며 과거 읽기 도구 이름도 호환성 차원에서 인식합니다.
압축 후에도 예산을 초과할 때에만 마지막 수단으로 도구 결과를 잘라냅니다. 도구 결과 예산은 창의 20%이며 8192–32768 토큰으로 제한합니다. 압축할 내용이 없거나 확보 공간이 5% 미만이면 현재 메시지 수를 기록해 같은 컨텍스트 크기에서 모델 호출 비용을 반복 지출하지 않도록 합니다. 압축에 성공하면 이전 usage 기준선을 지우고 context_compacted 이벤트를 발행합니다. 이벤트에는 압축 전후 토큰/메시지 수, 이유, split_turn, degraded가 포함됩니다.
제공업체가 컨텍스트 초과를 보고하면(오류 또는 응답 잘림 판정 기준), 강제 압축 후 한 번 재시도할 수도 있습니다. 생성이 completion 예산만 소진해서 잘린 경우는 컨텍스트 초과로 오판해서는 안 됩니다. 제공업체별 오류 식별은 internal/agent/compaction/overflow.go를 참고하세요.
세션 이력(agent_history)
턴 간 이력은 LoadAgentHistory(internal/application/service/agent_history.go)가 매 턴 messages 테이블에서 재구성합니다(DB가 유일한 진실의 원천이며 Redis/메모리 캐시는 없음).
- 원본 메시지
HistoryTurns × 4개(최소 50개)를 가져오고RequestID로 user/assistant를 짝지어 assistant가 완료된(IsCompleted) 완전한 턴만 남깁니다. 시간순으로 정렬해 최근HistoryTurns턴을 선택합니다. - 각 턴은 다음과 같이 펼칩니다. user 메시지(이미지 caption과 첨부 파일 prompt 포함; 과거 렌더링 프로토콜이 컨텍스트에 들어오지 않도록
RenderedContent스냅샷은 무시) → 도구 호출이 있는 각AgentStep을 assistant(with tool_calls) + 여러 tool 메시지로 확장 → 마지막에 정규화한 최종 답변 assistant 메시지 하나(<think>블록 제거). - 이력의 tool 메시지 내용은
CompactToolOutputForHistory(internal/agent/tools/persist.go)로 압축합니다.display_type이 있는 큰 페이로드(예:knowledge_chunks_list의 chunks,grep_results의 chunk_results)는 한 줄 요약으로 바꿉니다(예:"Listed 20/87 chunks from X (content omitted from history)").
엔진에 진입한 뒤 buildMessagesWithLLMContext는 과거 KB 결과 마스킹(redactHistoryKBResults)도 수행합니다. Agent에서 RetainRetrievalHistory를 켜지 않았다면, 과거 턴의 KB 도구(knowledge_search, grep_chunks, list_knowledge_chunks, query_knowledge_graph, get_document_info, wiki_search, wiki_read_page, wiki_read_source_doc) 결과를 모두 "[Previous retrieval result omitted — knowledge base may have changed. Please perform a fresh search.]"로 바꾸어 변경되었을 수 있는 지식 베이스를 새로 검색하도록 강제합니다.
영구 저장 측에서는 SanitizeAgentStepsForStorage가 AgentSteps를 DB에 쓰거나 SSE로 재생하기 전에 LLM-only 대형 페이로드를 제거하고 간결한 요약만 남깁니다.
스킬(Skills) 시스템
사용 절차, 설치 출처, 샌드박스 연결, 네트워크 정책, 환경 변수는 스킬 디렉터리와 샌드박스를 참고하세요. 스킬은 에이전트가 선택한 공간 샌드박스 설정에 의존하며, 운영 대화에서는 호스트의 skills/preloaded를 로드하지 않습니다.
점진적 로드와 범위
스킬 패키지에는 YAML frontmatter를 가진 SKILL.md와 scripts/templates 등의 리소스가 포함됩니다. 모델은 먼저 이름과 설명(Level 1)을 보고, read_file(path="skill://<name>/SKILL.md")로 전체 설명(Level 2)을 읽은 뒤 필요에 따라 추가 리소스(Level 3)를 읽습니다. 읽기 결과에는 실제 실행 방법, 사용 가능한 파일, 스킬 디렉터리 정보도 함께 제공됩니다.
skills_selection_mode는 all/selected/none이며 selected는 selected_skills로 지정합니다. 런타임에는 선택한 샌드박스에 설치되어 있고 사용 가능한 스킬만 노출합니다. @스킬은 이미 승인된 멘션을 이번 턴의 우선 항목으로 기록할 뿐, 원래 허용 목록을 좁히거나 원래 사용할 수 없던 스킬에 권한을 부여하지 않습니다.
통합 진입점은 read_file과 shell_exec(skill_name=..., command=...)입니다. 기존 read_skill, execute_skill_script는 더 이상 등록하지 않습니다. 스킬 파일 URI는 shell 경로가 아닙니다. 패키지 안의 스크립트는 읽기 결과가 제공한 디렉터리나 $WEKNORA_SKILL_DIR을 사용해 실행합니다. 공간 샌드박스 설정을 선택하지 않으면 스크립트를 실행할 수 없습니다.
세션 환경과 파일
Docker, Cube, E2B는 모두 세션 단위 샌드박스를 제공합니다. 첨부 파일 임시 저장, shell 실행, 산출물 수집은 같은 인스턴스를 재사용합니다. 샌드박스 식별자는 세션에 연결되며 도구 매개변수로 다른 공간의 실행 환경으로 바꿀 수 없습니다. 기본 실행 계정은 샌드박스 내부 root이고 격리 경계는 샌드박스 자체입니다. Docker는 기본적으로 비활성화되어 있으며 활성화 조건은 스킬 디렉터리와 샌드박스를 참고하세요.
| 경로 | 용도 |
|---|---|
/workspace/input | 채팅 첨부 파일 임시 저장 |
/workspace | 이번 턴 또는 후속 턴에서 사용할 작업 파일, 스크립트 |
/workspace/output | 수집, 미리보기, 다운로드 가능한 전달 파일 |
skill://<name>/... | 스킬 패키지 리소스 읽기 주소 |
web://... | 이 세션에 영구 저장된 웹페이지 스냅샷. 샌드박스 없이도 읽기 가능 |
샌드박스 유휴 TTL, 스킬 이미지 갱신 또는 재생성은 인스턴스의 임시 상태에 영향을 줄 수 있습니다. 대화 산출물 수집은 세션과 대화 경험, API는 샌드박스와 스킬 API를 참고하세요.
파일 도구 계약
- 쓰기:
write_sandbox_file은 /workspace 아래 파일만 쓰며 읽기 전용 입력 디렉터리 /workspace/input은 제외합니다. overwrite/append를 지원하며 파일당 최대 8 MiB입니다. 모델 출력 한도는 생성 전 예산에 사용하며, 완전한 파일 내용을 거부하기 위한 예측 바이트 임계값으로 사용하지 않습니다. 잘린 도구 호출은 실행 전에 거부하여 불완전한 내용을 파일에 쓰지 않도록 합니다. - 읽기:
read_file은 1부터 시작하는 offset 행 번호를 사용하고 limit은 기본 2000행이며 max_bytes와 도구 출력 예산의 제한을 받습니다. 잘리면 반환된 next_offset으로 이어 읽습니다. 작업 공간 텍스트는 페이지당 최대 64 KiB, 웹페이지 스냅샷은 페이지당 최대 50 KiB입니다. 지나치게 긴 행은 line_offset으로 이어 읽습니다. 바이너리는 텍스트로 직접 반환하지 않습니다. - 수정:
edit_sandbox_file은edits:[{old_string,new_string,replace_all?}]을 받으며, 모든 매칭은 같은 원본 버전을 기준으로 해석합니다. 매칭 실패, 모호성, 구간 중첩이 있으면 전체 묶음을 거부하고 부분적으로 쓰지 않습니다. - 동시성: append/edit는 읽기-수정-쓰기 작업이므로 세션과 파일 경로별로 직렬화합니다. 다른 경로는 병렬 처리할 수 있습니다.
- 스킬 패키지: 일반 작업 공간 파일 도구는 설치된 스킬 패키지를 직접 수정하지 않습니다. 설치와 유지 관리에는 전용 스킬 쓰기 도구를 사용하며, 일반 Agent의 범용 파일 편집 진입점으로 제공하지 않습니다.
제약은 도구 설명에 두고 시스템 프롬프트는 도구 선택과 도구 간 흐름만 설명합니다. 하위 파일 캐시는 세션, 경로, 크기, mtime, 파일 변경 epoch에 의존해 길이가 같은 편집 후에도 오래된 내용을 읽지 않도록 합니다.
실행 흐름
도구 승인 메커니즘(Human-in-the-Loop)
MCP 도구 승인은 internal/agent/approval/gate.go에서 구현합니다.
승인 범위: 승인 게이트(approval.MCPApproval)는 MCP 도구에만 연결됩니다. MCPTool.Execute(internal/agent/tools/mcp_tool.go)는 실제 MCP 서비스를 호출하기 전에 gate.NeedsApproval(tenantID, serviceID, toolName)을 확인합니다. 내장 도구는 승인을 거치지 않습니다. 승인 대상 MCP 도구는 Checker(DB의 MCPToolApprovalService를 approval.Adapter로 어댑트)가 테넌트+서비스+도구 이름별로 판정합니다.
Fail-close 기본값: NeedsApproval의 검사기에서 오류가 발생하면 기본적으로 승인을 요구합니다(HITL 기능에 더 안전). 환경 변수 WEKNORA_AGENT_TOOL_APPROVAL_FAIL_OPEN=true로 기존의 허용 동작을 복원할 수 있습니다.
승인 흐름(RequestAndWait):
pendingID(UUID)를 생성하고 waiter를 메모리 map에 등록합니다.- EventBus로
EventToolApprovalRequired(서비스 이름, MCP 도구 이름, 매개변수 JSON, 제한 시간(초), tool_call_id 등 포함)를 발행하면 프런트엔드에 승인 카드가 표시됩니다. - 사용자
Resolve, 시간 초과(기본 10분,cfg.Agent.ToolApprovalTimeoutSeconds로 설정 가능), 요청 ctx 취소 중 하나를 블로킹 대기합니다. 결과는 모두EventToolApprovalResolved로 UI에 알립니다. Decision은Approved,Reason,ModifiedArgs를 지원합니다. 사용자는 승인 시 도구 매개변수를 수정할 수 있으며 MCPTool은 수정된 매개변수를 다시 파싱해 실행합니다.- 거부/시간 초과/취소는 모두 도구 실패 결과로 LLM에 반환합니다(전체 Agent를 중단하지 않음).
긴 대기와 실행 제한 시간의 조합: 일반 도구 실행은 60s로 제한되지만 승인은 더 오래 기다릴 수 있습니다. 엔진은 ToolExecContext.ApprovalCtx에 도구별 제한 시간이 없는 턴 단위 ctx를 전달해 승인 대기에 사용합니다. 승인 후 MCPTool은 ApprovalCtx에서 새 실행 제한 시간 창을 파생시켜, 승인 대기로 예산이 소진되어 승인 직후 시간 초과가 발생하는 일을 막습니다.
인스턴스 간 지원: waiter는 대기를 시작한 인스턴스 메모리에 있습니다. Redis 설정 시 Resolve가 로컬에서 찾지 못하면 Pub/Sub 채널 weknora:mcp_approval:resolve(WEKNORA_REDIS_NAMESPACE 접미사로 여러 배포 격리 가능)를 통해 모든 복제본으로 브로드캐스트합니다. waiter를 보유한 인스턴스가 전달하고 nonce를 포함한 per-pending 응답 채널로 ack를 돌려보내므로 HTTP 계층은 ok / not_found / tenant_mismatch / user_mismatch / already_resolved를 정확히 구분할 수 있습니다. Redis가 없으면 단일 프로세스 의미론으로 폴백합니다(고정 세션 필요).
권한 검증: Resolve 시 tenant 일치를 확인합니다. waiter에 userID가 등록되어 있으면 호출자도 동일하고 비어 있지 않은 userID를 보내야 합니다(빈 값은 불일치로 취급, fail-close). 이를 통해 다른 사람이 세션 소유자 대신 승인하는 일을 방지합니다.
세션 내 OAuth: 같은 Gate는 RequestOAuthAndWait도 제공합니다. MCP 전송 계층이 "권한 부여 필요" 오류를 반환하면(승인 테이블 조회가 아님), EventMCPOAuthRequired를 발행해 사용자가 대화 안에서 OAuth를 완료하도록 합니다. 최대 대기 시간은 Agent 설정의 MCPAuthWaitTimeout(internal/agent/tools/mcp_oauth.go)을 사용하며 권한 부여 성공 후 도구 호출을 자동 재시도합니다.
Agent 모드와 일반 RAG 질의응답 모드
두 질의응답 경로
라우팅 계층(internal/router/router.go)에는 두 진입점이 등록되어 있습니다.
knowledgeChat.POST("/:session_id", handler.KnowledgeQA)  // /knowledge-chat/:session_id
agentChat.POST("/:session_id", handler.AgentQA)          // /agent-chat/:session_id
둘 다 최종적으로 internal/handler/session/qa.go의 통합 실행 흐름 executeQA(reqCtx, mode, generateTitle)에 모이며, mode는 다음 둘 중 하나입니다.
const (
	qaModeNormal qaMode = iota // KnowledgeQA 파이프라인(RAG / 순수 채팅)
	qaModeAgent                // 도구 호출을 사용하는 Agent 엔진
)
모드 결정 로직
Handler.AgentQA는 다음 순서로 실행 모드를 선택합니다.
- 요청을 파싱하고
resolveAgent로agent_id에 해당하는CustomAgent를 해석합니다(내장 및 공유 Agent의 권한 검사 포함). CustomAgent.IsAgentMode()가 요청의agent_enabled필드보다 우선합니다. 즉Config.AgentMode == "smart-reasoning"일 때만 Agent를 사용하며,quick-answer형 Agent는/agent-chat으로 요청해도 일반 모드로 전환됩니다.- agent 모드가 성립하지만
customAgent == nil이면(대표 사례: 프런트엔드 localStorage의selectedAgentId가 지워졌지만 스위치는 남아 있음) 400"agent_id is required when agent mode is enabled"를 조기 반환하여 비동기 스트림에서 이해하기 어려운 오류가 발생하지 않게 합니다. - 성립하면 →
executeQA(reqCtx, qaModeAgent, true). 그렇지 않으면"Agent mode disabled, delegating to normal mode"로그를 남기고qaModeNormal을 사용합니다.
임베드 채널(internal/handler/embed_channel.go의 delegateEmbedChat)도 같습니다. agentMode && ch.AgentID != types.BuiltinQuickAnswerID일 때만 AgentQA로 전달하고, 아니면 KnowledgeQA로 전달합니다.
두 경로의 차이
| 구분 | 일반 RAG(qaModeNormal) | Agent(qaModeAgent) |
|---|---|---|
| 실행 주체 | KnowledgeQA chat pipeline(의도 인식→재작성→검색→rerank→context 구성→단일 생성) | AgentEngine.Execute의 ReAct 다중 반복 루프 |
| 검색 방식 | 파이프라인에 고정된 벡터/키워드 혼합 검색 | LLM이 도구를 자율 선택(의미/정규식/그래프/Wiki/Web/SQL…), 여러 차례 반복 가능 |
| 서비스 진입점 | sessionService.KnowledgeQA | sessionService.AgentQA(req.CustomAgent != nil 필수) |
| 이력 | 파이프라인 자체의 멀티턴 재작성과 이력 구성 | LoadAgentHistory로 assistant+tool 메시지 단위 이력 재구성 |
| 결과 영구 저장 | 단일 답변 | 답변 + AgentSteps(사고/도구 호출 트리), SSE 재생 가능 |
| KB 호환성 | vector 또는 keyword 인덱스를 암묵적으로 요구(quickAnswerKBFilter) | allowed_tools의 capabilities에서 파생 |
sessionService.AgentQA(internal/application/service/session_agent_qa.go)는 엔진 진입 전에 공유 Agent의 테넌트 전환, 비전 모델 라우팅(모델이 vision을 지원하면 이미지를 직접 전달하고, 아니면 VLM 설명을 query에 합침), 인용 컨텍스트/첨부 파일 내용의 query 병합, 필요 시 rerank 모델 초기화 등도 처리합니다. 실행은 비동기이며 이벤트는 EventBus를 통해 Handler 계층으로 스트리밍됩니다.
주요 상수 빠른 참고
| 상수 | 값 | 위치 |
|---|---|---|
DefaultAgentMaxIterations | 20 | internal/agent/const.go |
MAX_ITERATIONS(서비스 계층 상한) | 100 | internal/application/service/agent_service.go |
defaultLLMCallTimeout | 120s | internal/agent/const.go |
defaultToolExecTimeout | 60s | internal/agent/const.go |
maxLLMRetries | 2 | internal/agent/const.go |
maxEmptyResponseRetries | 2 | internal/agent/const.go |
maxRepeatedResponseRounds | 2 | internal/agent/const.go |
DefaultMaxToolOutput | 16000 rune(앞 70% / 뒤 30%) | internal/agent/tools/truncate.go |
DefaultMaxContextTokens | 200000 | internal/types/agent.go |
DefaultReserveTokens | 16384(출력 예산이 크면 증가) | internal/agent/compaction/settings.go |
DefaultKeepRecentTokens | 20000(작은 창에서는 감소) | internal/agent/compaction/settings.go |
| 승인 기본 제한 시간 | 10분 | internal/agent/approval/gate.go |
| shell_exec 기본 제한 시간 | 120s, 상한 600s; 리소스 한도는 샌드박스 백엔드 설정 사용 | internal/agent/tools/shell_exec.go |
| 스킬 이름 제한 | name ≤ 64, description ≤ 1024 | internal/agent/skills/skill.go |