

모델 관리
‘설정 → 모델’에서 대화, 벡터, 리랭킹, 비전, 음성 모델을 추가한 뒤 지식 베이스나 에이전트에서 필요에 따라 선택합니다. 로컬 Ollama와 원격 모델을 조합할 수도 있습니다. 예를 들어 로컬 모델로 벡터를 생성하고 원격 모델로 답변을 생성할 수 있습니다.
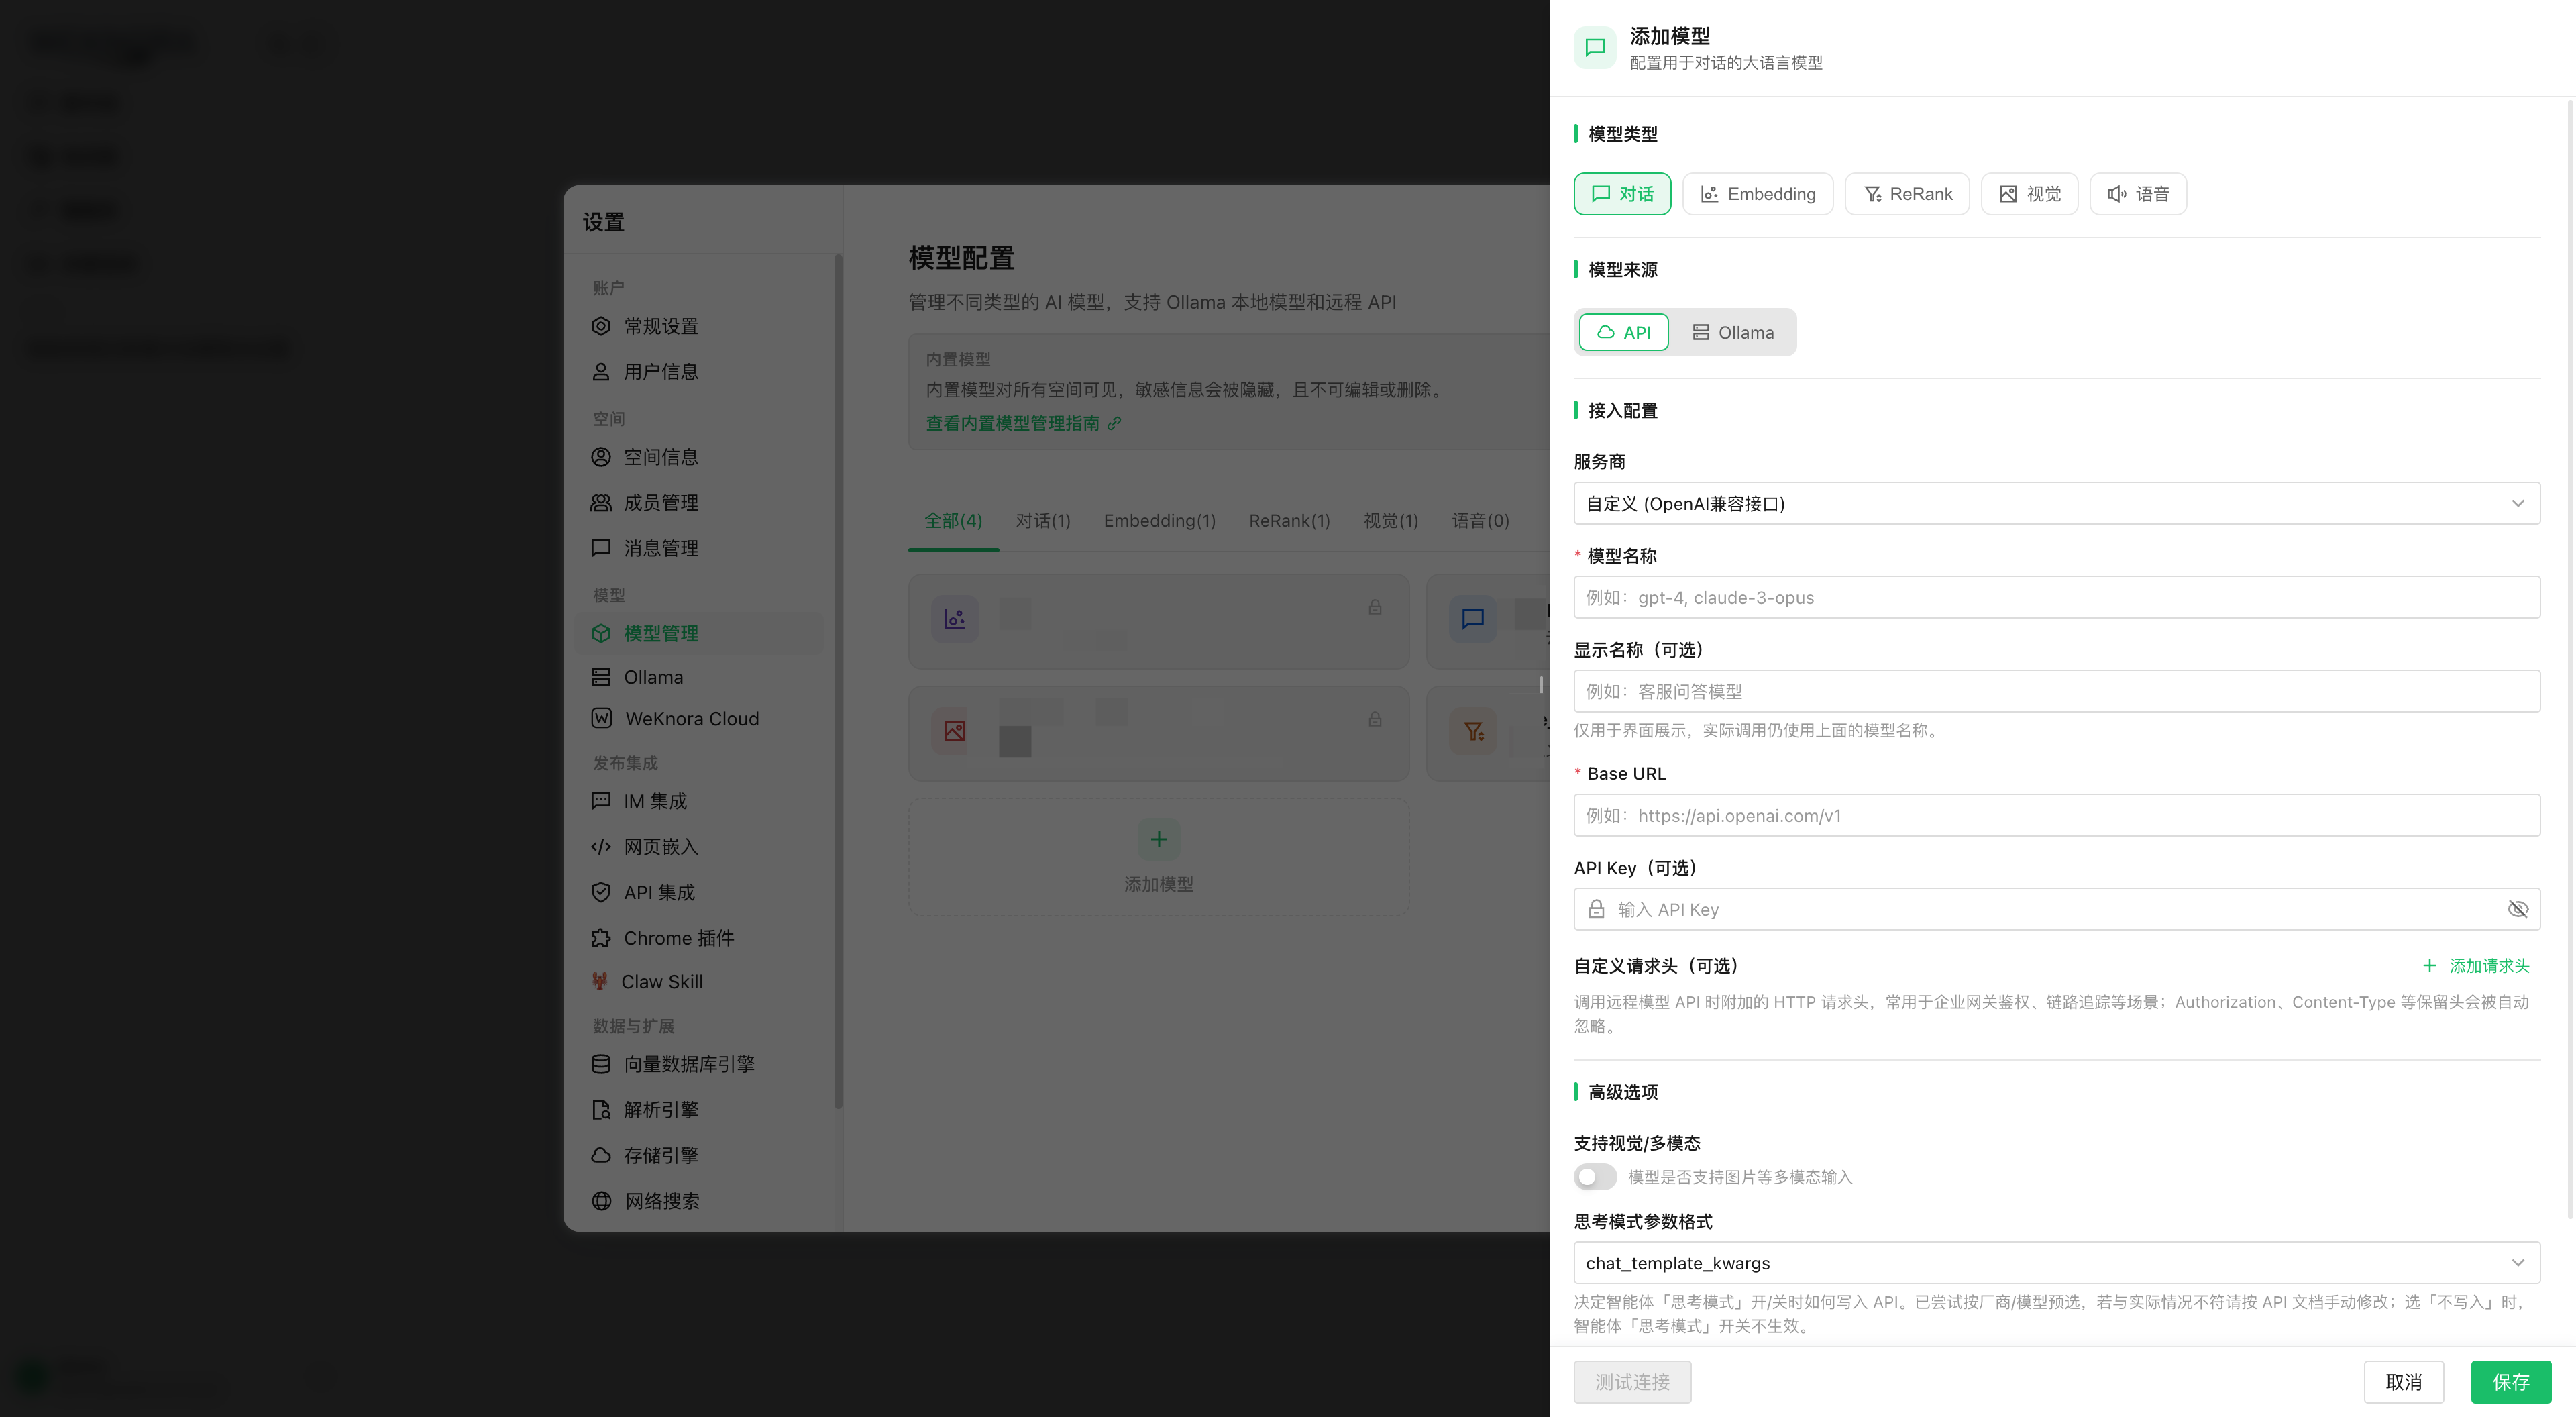
모델 목록(이름, 유형, 출처, 기본 모델 표시)과 ‘모델 추가’ 양식, 연결 테스트 결과를 보여 줍니다.
website-docs/public/screenshots/settings-models.png모델을 추가할 때는 연결 설정과 인덱스 호환성을 확인해야 합니다.
- 벡터 모델을 바꾸면 인덱스를 재구축해야 합니다. 모델이 벡터의 의미 공간과 차원을 결정하므로 새 벡터와 기존 벡터를 바로 섞어 쓸 수 없습니다.
- 저장 전에 연결을 테스트합니다. 서비스 주소, 자격 증명, 모델 이름이 유효한지 확인한 뒤 지식 베이스나 에이전트에 사용합니다.
모델 유형, 설정 필드, 사용 상태는 아래 설명을 참고하세요.
모델 유형 선택
| 유형 | 용도 |
|---|---|
| 대화 모델 | 질의응답, 요약, 지능형 추론 내용 생성 |
| 벡터 모델 | 문서와 질문을 벡터로 변환하여 의미 검색 지원 |
| 리랭킹 모델 | 검색한 조각의 순서 재정렬 |
| 비전 모델 | 문서나 대화의 이미지 인식 |
| 음성 모델 | 오디오를 텍스트로 전사 |
추가와 연결 검증
모델 설정에서 유형과 제공자를 선택하고 실제 모델 이름, 서비스 주소, 자격 증명을 입력한 뒤 테스트를 통과하면 저장합니다. 벡터 모델은 인덱스 차원과 맞아야 합니다. 대화 및 비전 모델의 컨텍스트 창은 대화 이력 압축이 올바르게 실행되도록 서비스가 실제 지원하는 크기를 사용해야 합니다.
연결 주소를 수정할 때는 저장된 자격 증명으로 테스트할 수 있습니다. 모델 디버거는 실제 요청을 보내고 소요 시간, 민감 정보를 가린 요청, 응답 결과를 표시합니다. 벡터 차원, 리랭킹 점수, 스트리밍 출력을 확인하는 데 사용할 수 있습니다.
참조 확인과 설정 조정
지식 베이스와 에이전트는 모델 참조를 저장합니다. 모델을 삭제하기 전에 의존성 상세를 확인해야 합니다. 내장 모델은 YAML 설정으로 관리하므로 설정 파일에서 유지보수해야 합니다. 호출량과 캐시 사용 현황은 관측 가능성과 감사에서 함께 확인할 수 있습니다.
설정과 호출 참고
모델 유형과 용도
모델 유형은 internal/types/model.go에 정의되어 있습니다.
const (
    ModelTypeEmbedding   ModelType = "Embedding"   // 임베딩 모델
    ModelTypeRerank      ModelType = "Rerank"      // 리랭킹 모델
    ModelTypeKnowledgeQA ModelType = "KnowledgeQA" // 지식 질의응답 모델
    ModelTypeVLLM        ModelType = "VLLM"        // VLLM 모델
    ModelTypeASR         ModelType = "ASR"         // ASR 모델
)| 유형 | 프런트엔드 식별자 | 클라이언트 패키지 | 인터페이스 | 용도 |
|---|---|---|---|---|
KnowledgeQA | chat | internal/models/chat | Chat / ChatStream(Tools, Thinking, 멀티모달 메시지 지원) | 지식 질의응답, Agent 추론, 요약 / 질문 생성 / 그래프 추출 등 모든 LLM 호출 |
Embedding | embedding | internal/models/embedding | Embed / BatchEmbed(GetDimensions 포함) | 벡터 검색 인덱스와 질의를 위한 텍스트 벡터화 |
Rerank | rerank | internal/models/rerank | Rerank(query, documents)가 RankResult 반환 | 검색 결과 정밀 순위 조정 |
VLLM | vllm | internal/models/vlm | Predict(imgBytes, prompt) | 비전 언어 모델(VLM), 문서 이미지 이해 / 멀티모달 파싱 |
ASR | asr | internal/models/asr | Transcribe(audioBytes, fileName)이 텍스트와 구간별 타임스탬프 반환 | 오디오 전사(자동 음성 인식) |
프런트엔드와 백엔드 유형 매핑은 internal/handler/model.go의 modelTypeToFrontend()(KnowledgeQA -> chat 등)를 참고하세요.
모델 출처(ModelSource)의 핵심 값은 local(로컬 Ollama로 실행)과 remote(원격 API) 두 가지입니다. 나머지 과거 값(aliyun, zhipu, openai 등)은 호환성을 위해 유지하며 라우팅 동작은 remote + 해당 provider와 같습니다.
모델 설정 필드
모델 엔터티 types.Model의 Parameters(internal/types/model.go의 ModelParameters):
| 이름 | 유형 | 기본값 | 설명 |
|---|---|---|---|
base_url | string | 빈 값(Provider의 DefaultURLs 사용 가능) | 모델 API 주소, 생성/수정 시 SSRF 검증(ValidateURLForSSRF) 수행 |
api_key | string | 빈 값 | API 키, AES-256-GCM으로 암호화하여 DB 저장(ModelParameters.Value/Scan), PUT /models/:id/credentials 하위 리소스로만 수정 가능 |
interface_type | string | 빈 값(VLM: local 기본 ollama, remote 기본 openai) | 인터페이스 프로토콜 유형 |
embedding_parameters.dimension | int | 0 | 벡터 차원 |
embedding_parameters.truncate_prompt_tokens | int | 0 | 입력을 자를 token 수 |
embedding_parameters.supports_dimension_override | bool | false | 요청 수준 차원 재정의(dimensions 매개변수) 지원 여부 |
parameter_size | string | 빈 값 | Ollama 모델 매개변수 규모(예: "7B"), 백엔드가 관리하며 프런트엔드에서 수정 불가 |
provider | string | 빈 값(BaseURL로 자동 감지) | 제공자 식별자 |
extra_config | map[string]string | nil | 제공자 전용 설정(예: Azure의 api_version) |
custom_headers | map[string]string | nil | 추가 사용자 정의 HTTP 요청 헤더(OpenAI SDK extra_headers와 유사, Authorization, api-key 등 예약 헤더는 런타임에 무시) |
supports_vision | bool | false | Chat 모델의 이미지 멀티모달 입력 수락 여부 |
context_window | int | 0(200000으로 대체) | 대화/VLM 컨텍스트 창(token). 에이전트의 이력 압축이 이 상한에 따라 동작. 빈 값이면 기본 200K 사용. 너무 높으면 압축이 제때 실행되지 않으므로 서비스가 실제 지원하는 창 크기 입력 |
max_concurrency | int | 0(전역 model.max_concurrency로 대체) | 이 모델의 백그라운드 작업 동시 실행 상한(chat/vlm/embedding에만 적용) |
app_id / app_secret | string | 빈 값 | WeKnoraCloud 전용 자격 증명, app_secret은 AES 암호화 저장 |
모델 수준 필드에는 name(런타임에 실제 호출하는 모델 이름), display_name, type, source, is_default(동일 (tenant_id, type) 그룹에서 유일한 기본 모델), is_builtin, managed_by, status(active / downloading / download_failed)도 있습니다.
관리 API(internal/router/router.go)
| 메서드 & 경로 | 설명 |
|---|---|
GET /models/providers | model_type별 지원 제공자 목록 조회(ListModelProviders) |
POST /models / GET /models / GET /models/:id / PUT /models/:id / DELETE /models/:id | 모델 CRUD |
PUT /models/:id/credentials, DELETE /models/:id/credentials/:field | 자격 증명 하위 리소스. PUT /models/:id 요청 본문의 api_key는 강제로 무시하고 경고 기록 |
POST /models/:id/debug | 모델 디버깅(아래 참고) |
GET /models/weknoracloud/status | WeKnoraCloud 자격 증명 상태 |
모델 상태 확인 / 연결 테스트
두 메커니즘 모두 서버 측에서 자격 증명을 보유하며 평문 키를 반환하지 않습니다.
연결 테스트(
internal/handler/initialization.go, 모델 생성/편집 양식의 ‘연결 테스트’ 버튼용):POST /initialization/remote/check— Chat 모델(CheckRemoteModel/checkChatModelConnection)POST /initialization/embedding/test— Embedding(TestEmbeddingModel)POST /initialization/rerank/check— Rerank(CheckRerankModel)POST /initialization/asr/check— ASR(CheckASRModel)POST /initialization/multimodal/test— VLM 멀티모달 파싱(TestMultimodalFunction)
요청 본문
ModelTestRequest에는modelId를 포함할 수 있습니다.fillSecretsFromStoredModel은 요청에서 빠진APIKey/AppSecret을 저장된 모델에서 복호화하여 채웁니다. 따라서 프런트엔드가 평문 키를 얻을 필요도 없고 얻을 수도 없는 상태에서 ‘BaseURL을 바꾸고 기존 키로 한 번에 검증’할 수 있습니다.buildTestModel은 요청을 DB에 저장하지 않는 임시*types.Model로 변환하며 프로덕션 경로와 같은ConfigFromModel매핑을 공유합니다.모델 디버거(
POST /models/:id/debug,ModelHandler.DebugModel): 저장된 모델에 유형별 실제 호출을 수행하고 정규화된 전체 응답을 반환합니다. Chat은 스트리밍을 사용하고stream_events/ thinking 관측 항목을 집계합니다. Embedding은 벡터와 차원, Rerank는 점수 결과를 반환하며 VLM / ASR은 파일 업로드를 받습니다. 응답에는elapsed_ms, 민감 정보를 가린 요청 미리보기(redactedDebugConfig가 secret/token/api_key 계열 필드 숨김),observations가 포함됩니다.
내장 모델 메커니즘
internal/types/builtin_models_config.go는 선언적 내장 모델을 구현합니다. 시작 시 config/builtin_models.yaml(또는 BUILTIN_MODELS_CONFIG 지정 경로, 템플릿은 config/builtin_models.yaml.example)을 읽고 각 항목을 models 테이블에 UPSERT합니다. is_builtin=true, managed_by="yaml", 기본 tenant_id=10000(DefaultBuiltinModelTenantID)이며 모든 테넌트에 표시됩니다.
주요 동작(LoadBuiltinModelsConfig):
- 모든 문자열 필드는
${ENV_NAME}환경 변수 보간을 지원합니다. 설정하지 않은 변수는 설정 오류를 드러내기 위해 리터럴로 유지합니다. - 시작할 때마다
id기준 UPSERT하고deleted_at을 강제로 NULL로 재설정합니다(파일에 다시 나타난 항목은 복구됨). - 설정 이탈 정리:
managed_by='yaml'이지만 파일에 id가 없는 행은 소프트 삭제합니다. YAML에서 항목을 삭제하는 것이 내장 모델을 내리는 공식 방법입니다. - 관리자가 런타임에 행을 직접 관리하도록 전환하면(
managed_by를 빈 값으로) YAML 로더는 해당 행을 건너뜁니다("preserving runtime override"). is_default: true항목은 먼저 같은(tenant_id, type)그룹의 다른 기본 설정을 해제하여 API 경로와 동일한 유일 기본값 불변식을 유지합니다.- 검증 규칙: id는 비어 있지 않고 ≤64자(
ModelIDMaxLen), type은KnowledgeQA | Embedding | Rerank | VLLM | ASR, status는 유효한 값 또는 빈 값이어야 합니다. YAML 파싱 실패 시 동기화를 중단하고 설정 이탈 정리도 수행하지 않습니다.
YAML 예시(builtin_models.yaml.example 발췌):
builtin_models:
  - id: builtin-llm-default
    type: KnowledgeQA
    source: remote
    is_default: true
    name: ${LLM_MODEL_NAME}
    parameters:
      base_url: ${LLM_BASE_URL}
      api_key: ${LLM_API_KEY}
      provider: ${LLM_PROVIDER}
로컬 모델 다운로드(Ollama)
로컬 모델 수명 주기는 internal/models/utils/ollama/ollama.go의 OllamaService가 관리합니다(IsModelAvailable / PullModel / EnsureModelAvailable / ListModelsDetailed / DeleteModel 등). HTTP 진입점은 internal/handler/initialization.go에 있습니다.
| 경로 | 설명 |
|---|---|
GET /initialization/ollama/status | Ollama 서비스 가용성 |
GET /initialization/ollama/models | 로컬에 있는 모델 목록 |
POST /initialization/ollama/models/check | 모델 다운로드 여부 일괄 확인 |
POST /initialization/ollama/models/download | 비동기 다운로드(downloadModelAsync + pullModelWithProgress, 모델에 status=downloading 기록) |
GET /initialization/ollama/download/progress/:taskId, GET /initialization/ollama/download/tasks | 다운로드 진행률 / 작업 목록 |
주의:
cmd/download/duckdb/duckdb.go는 모델과 관련이 없습니다. 이미지 빌드 시 데이터 분석 도구용 DuckDBspatial,excel확장을 미리 내려받습니다. 모델 가중치 다운로드는 Ollama 경로에서만 발생합니다.
모델 사용량 통계
Token 사용량:
types.TokenUsage(internal/types/chat.go)는prompt_tokens / completion_tokens / total_tokens와 prompt cache 세부 항목(cache_read_tokens / cache_write_tokens / cache_miss_tokens / cache_status)을 기록합니다. 각 Chat 구현은internal/models/chat/usage.go의logUsage로 통일된 구조화 로그 행을 출력합니다.gologger.Infof(ctx, "[LLM Usage] model=%s, purpose=%s, prompt_prefix=%s, prompt_tokens=%d, completion_tokens=%d, ...", ...)purpose는types.WithLLMCallMetadata에서 가져오며(예:document_summary,entity_extraction) 용도별 집계에 사용할 수 있습니다.분산 추적: Langfuse를 켜면 모델 유형마다
langfuse_wrapper.go데코레이터가 호출(usage 포함)을 trace/span으로 보고합니다.스트리밍 응답: usage는 마지막
StreamResponse이벤트와 함께 반환합니다(모델 디버거는 이를usage필드에 집계).동시 실행 현황: 앞 절에서 설명한 대로
GET /system/admin/runtime/queues가 모델별 실시간active / waiting / limit을 제공합니다.
모델 호출과 구현 참고
Provider 추상화
internal/models/provider/provider.go는 다중 제공자 어댑터의 통합 레지스트리를 정의합니다.
type Provider interface {
    // Info는 제공자의 메타데이터를 반환합니다.
    Info() ProviderInfo
    // ValidateConfig는 제공자 설정을 검증합니다.
    ValidateConfig(config *Config) error
}
각 제공자는 자신의 파일(예: provider/openai.go, provider/aliyun.go)에서 init()을 통해 Register()를 호출하여 등록합니다. ProviderInfo에는 DisplayName, Description, 모델 유형별 DefaultURLs, 지원 ModelTypes, RequiresAuth, 선택적 ExtraFields가 포함됩니다(예: Azure OpenAI는 기본값 2024-10-21인 추가 필드 api_version 선언).
지원 제공자 목록
AllProviders()(provider/provider.go)가 반환하는 전체 목록입니다(총 27개, 각 제공자가 자신의 파일에서 init()으로 등록). 마지막 행의 Ollama는 목록에 포함되지 않고 source=local 독립 경로를 사용하며, 비교 편의를 위해 함께 표시했습니다.
| Provider 식별자 | 이름 | 설명 |
|---|---|---|
generic | Generic | 모든 OpenAI 호환 / 사용자 정의 배포(기본 대안) |
weknoracloud | WeKnoraCloud | WeKnora 클라우드 서비스(https://weknora.weixin.qq.com 하드코딩, AppID/AppSecret 자격 증명 사용) |
aliyun | Alibaba Cloud DashScope | |
zhipu | Zhipu AI(GLM 계열) | |
volcengine | Volcengine Ark | |
hunyuan | Tencent Hunyuan | |
siliconflow | SiliconFlow | |
deepseek | DeepSeek | |
minimax | MiniMax | |
moonshot | Moonshot(Kimi) | |
modelscope | ModelScope | |
qianfan | Baidu Qianfan | |
qiniu | Qiniu Cloud | |
openai | OpenAI | 다섯 모델 유형 모두 지원 |
anthropic | Anthropic Claude | 독립 Messages 프로토콜 구현 |
gemini | Google Gemini | Embedding은 전용 API 사용 |
openrouter | OpenRouter | |
litellm | LiteLLM(자체 호스팅 OpenAI 호환 프록시) | 기본 URL은 자리표시자이며 loopback은 SSRF_WHITELIST에 추가 필요 |
requesty | Requesty | |
jina | Jina AI | Embedding과 Rerank |
mimo | Xiaomi MiMo | |
longcat | Meituan LongCat AI | |
lkeap | Tencent Cloud LKEAP(지식 엔진 원자 기능) | 전용 Rerank 구현 제공 |
gpustack | GPUStack(프라이빗 배포) | |
nvidia | NVIDIA | 전용 Embedding / Rerank 구현 |
novita | Novita AI | |
azure_openai | Azure OpenAI | 추가 필드 api_version |
ollama(source=local) | Ollama 로컬 모델 | Provider 레지스트리 구성원이 아니며 ModelSourceLocal로 라우팅 |
모델에 provider를 명시하지 않으면 DetectProvider(baseURL)가 BaseURL 도메인 특징으로 자동 식별합니다(예: dashscope.aliyuncs.com -> aliyun, api.anthropic.com -> anthropic). 식별하지 못하면 generic으로 폴백합니다.
프로토콜 라우팅
internal/models/chat/chat.go의 NewRemoteChat:
func NewRemoteChat(config *ChatConfig) (Chat, error) {
    providerName := provider.ProviderName(config.Provider)
    if providerName == "" {
        providerName = provider.DetectProvider(config.BaseURL)
    }
    if providerName == provider.ProviderAnthropic {
        return NewAnthropicChat(config) // 독립 Messages 프로토콜
    }
    return NewRemoteAPIChat(config) // 통합 OpenAI 호환 프로토콜 + providerAdapter
}- Ollama(
source=local):chat/ollama.go,embedding/ollama.go,vlm/ollama.go가internal/models/utils/ollama의OllamaService를 통해 로컬 Ollama에 직접 연결합니다. - Anthropic:
chat/anthropic.go가 Messages 프로토콜을 구현합니다. - 나머지 원격 제공자: 모두
chat/remote_api.go의 OpenAI 호환 Chat Completions 구현을 사용합니다. 제공자 차이(thinking 인코딩, 매개변수 호환 등)는 생성 시 결정하는providerAdapter가 처리합니다. - Embedding에는 더 많은 전용 구현이 있습니다. Alibaba Cloud 멀티모달(
tongyi-embedding-vision-*는 DashScope 전용 엔드포인트 사용, 일반 텍스트 모델은/compatible-mode/v1OpenAI 호환 엔드포인트로 자동 변경), Volcengine 멀티모달, Jina, Azure OpenAI, NVIDIA, Gemini, Zhipu, WeKnoraCloud이며 나머지는 OpenAI 호환(embedding/openai.go)입니다. - Rerank 전용 구현: Aliyun, Zhipu, Jina, NVIDIA, WeKnoraCloud, LKEAP, Volcengine. 기본은
NewOpenAIReranker(일반/rerank스타일 인터페이스)입니다. 두 제공자에는 추가 어댑터가 있습니다.- LKEAP: Tencent Cloud
RunRerank는 한 번에 최대 60개 문서, Query와 Docs 합계 2000자 이하로 제한됩니다.lkeapRerankBatches가 두 상한에 따라 자동으로 배치를 나누고 전역 인덱스를 다시 채우므로 호출자는 배치를 신경 쓰지 않아도 됩니다. 문서 하나가 자체적으로 상한을 넘으면 바로 오류를 반환하고 해당 인덱스를 알려 줍니다. - Volcengine: 후보 집합이 API의 단일 호출 문서 상한을 넘으면 여러 배치로 나눠 동시에 점수를 계산한 뒤 병합합니다(동시 실행 상한은
volcengineRerankMaxConcurrency참고). 후보를 조용히 잘라 버리지 않습니다. - NVIDIA: API는 [0,1] 확률이 아닌 원시 logit을 반환합니다.
normalizeNvidiaLogit이 수치적으로 안정적인 sigmoid로 정규화합니다(음수는e^x/(1+e^x)분기로 오버플로 방지). 그렇지 않으면 이 제공자에서RerankThreshold같은 임계값 설정이 전혀 작동하지 않습니다.
- LKEAP: Tencent Cloud
- ASR: 모든 제공자가 OpenAI 호환
/v1/audio/transcriptions를 사용합니다(asr/asr.go:NewASR이 곧바로NewOpenAIASR호출).
모델 호출 체인
팩터리 함수는 실제 클라이언트 바깥에 세 데코레이터를 순서대로 적용합니다(chat.NewChat / embedding.NewEmbedder / vlm.NewVLM 참고).
c, err = wrapChatDebug(c, err)
c, err = wrapChatLangfuse(c, err)
// 가장 바깥 계층: 실제 제공자 왕복 호출 동안만 모델별 동시 실행 슬롯을 점유하여
// 대기 시간이 debug/langfuse 측정 시간에 포함되지 않도록 합니다.
return wrapChatConcurrency(c, config.MaxConcurrency, err)
동시 실행과 제한(limiter)
internal/models/limiter는 모델 ID별 분산 백그라운드 동시 실행 게이트를 제공합니다. 핵심 설계(limiter.go 패키지 주석): 공유하는 희소 자원은 모델 제공자의 요청 예산이므로 asynq 대기열 계층이 아니라 모든 작업 유형을 볼 수 있는 유일한 위치인 모델 클라이언트 계층에서 제한합니다.
- Redis 백엔드(
NewRedisLimiter): 자가 복구형 분산 세마포어입니다. 점유 슬롯마다 ZSET 구성원(고유 token)이 있고 score는 임대 만료 시간입니다.acquireScriptLua 스크립트가 원자적으로 만료 임대를 정리하고 개수를 세어 한도 안에서 진입을 허용합니다. 임대 TTL은 30s이며 점유자는 TTL/3마다 하트비트로 갱신합니다(ZSET key 자체 TTL도 갱신). 프로세스가 비정상 종료되면 임대가 자연 만료되어 회수됩니다. 어떤 백엔드 오류에서도 fail-open합니다. 제한기 장애가 모델 트래픽을 막아서는 안 됩니다. - Local 백엔드(
NewLocalLimiter): Lite 모드(Redis 없는 단일 프로세스)의 프로세스 내 카운팅 세마포어입니다. - 백그라운드 작업만 제한:
GateNamedN(governor.go)은types.IsBackgroundTask(ctx)가 true일 때만 대기시킵니다(asynq worker: 요약, 질문 생성, 그래프 추출, 멀티모달 보강 등). 대화형 사용자 요청은 이 게이트로 차단하지 않습니다. - 한도는 모델 자체
parameters.max_concurrency를 우선 사용하고, 0이면 프로세스 수준 기본값model.max_concurrency를 사용합니다(시스템 설정에서 런타임에SetGlobalLimit으로 동적 갱신 가능). - 런타임 관측:
GET /system/admin/runtime/queues(internal/handler/system.go)는limiter.RuntimeStats()의 모델별active / waiting / limit을 반환합니다(Redis 백엔드의 active는 클러스터 수준, waiting은 프로세스 로컬).
rerank_server_demo.py의 용도
저장소 루트의 rerank_server_demo.py는 자체 호스팅 Rerank 서비스의 최소 참조 구현입니다. FastAPI + HuggingFace AutoModelForSequenceClassification을 사용하며 POST /rerank를 제공합니다. 요청 본문은 {query, documents}, 응답은 {"results": [{index, document: {text}, score}]}입니다.
예시 서비스는 score 필드를 반환하므로 클라이언트 호환성을 검증하는 데 사용할 수 있습니다. RankResult.UnmarshalJSON은 relevance_score를 우선 읽고 없으면 score를 읽습니다. DocumentInfo.UnmarshalJSON은 문자열과 {text} 객체를 모두 받습니다. 이 프로토콜을 따르는 프라이빗 리랭킹 서비스는 generic provider로 연결할 수 있습니다.